管理员:LLM 容量管理
LLM 容量在行业层面是有限资源,所有提供商都会限制账户的最大可用容量。这一篇讲 AIP 如何在组织内分配这份稀缺资源。
https://www.palantir.com/docs/foundry/aip/llm-capacity-management/
原始标题:Administration • LLM capacity management • Palantir · 所属:核心平台(AIP 总览与治理)
先记住这几条
写在前面
LLM 容量在行业层面是一种有限资源,所有提供商(Azure、OpenAI、AWS Bedrock、Google Cloud Vertex 等)都会限制每个账户可用的最大容量。因此,Palantir AIP 遵循 LLM 提供商所设定的市场级约束。业界通用的计量单位是每分钟 token 数(TPM)和每分钟请求数(RPM)。
注册容量与速率限制
Palantir 为每个注册设定了特定的最大容量,称为「注册级速率限制(enrollment-level rate limits)」。该容量按模型使用 TPM 和 RPM 计量,涵盖你注册上启用的所有提供商的所有模型,包括 GPT、Claude、Gemini、Llama、Mixtral 等。这样一来,每个模型都拥有独立的容量,不受其他模型使用情况的影响。
AIP 中的 LLM 容量在三个层级上进行管理:注册级限制设定总体上限,项目速率限制控制每个项目可以使用多少该容量,用户速率限制则管控未归属于项目的流量中单个用户的消耗量。
默认情况下,所有客户都处于 medium 层级,该层级足够构建原型并扩展到少数用例,即便有数百名用户和大型数据集(例如包含数百万份文档)也是如此。
此外,如果你需要更多容量,AIP 提供了将注册容量从 medium 层级升级到 large 或 XL 层级的选项。如果你不断触及注册速率限制,阻碍了你扩展 AIP 使用,或者预计会增加流水线规模或用户总数,请联系 Palantir 支持。
注册限制现在显示在 Resource Management 应用的 AIP rate limits 标签页中,同时显示注册层级。
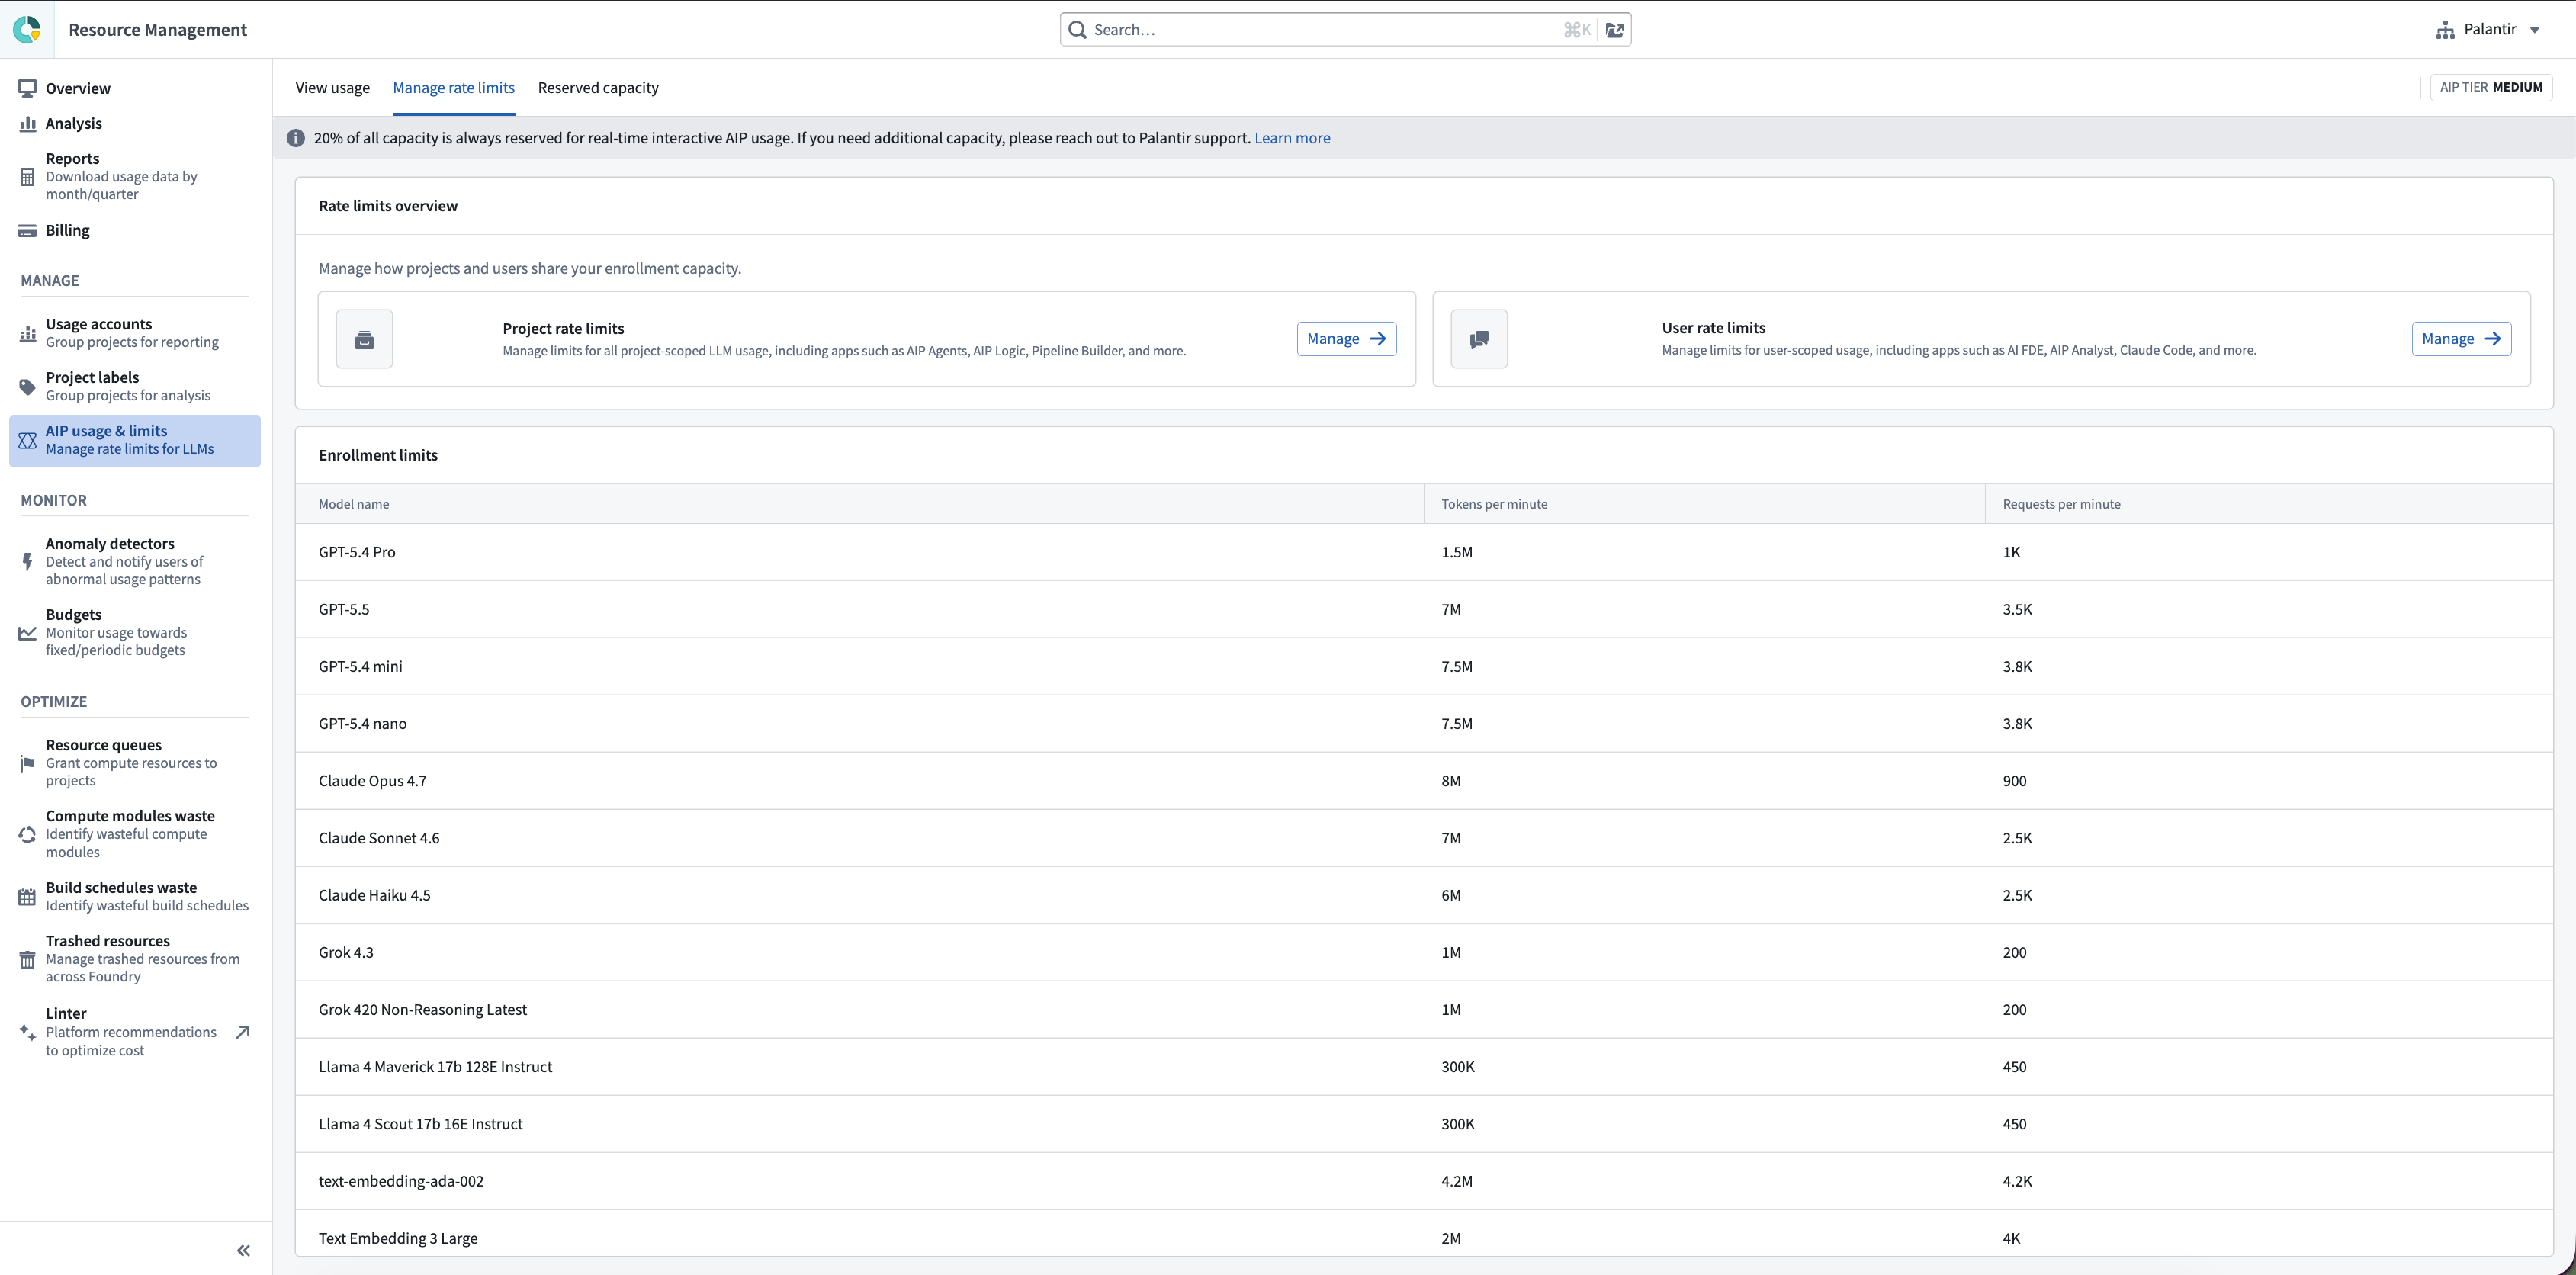
借助注册层级(尤其是 XL 层级),AIP 提供了足够的容量来构建大规模工作流。这些层级已为数百家大规模使用 LLM 的 Palantir 客户提供了足够的容量,并且我们会继续提高这些限制。
关于按模型和层级划分的完整注册速率限制明细,请参阅 LLM 注册速率限制。
AIP 用量与限制
注册管理员可以导航到 Resource Management 应用中的 AIP usage & limits 页面,以便:
- 查看用量:查看你注册中所有项目和资源对 Palantir 提供的所有模型的 LLM token 与请求用量。
- 管理速率限制:管理你注册的项目与用户速率限制。
- 项目速率限制: 按模型配置给定项目内所有资源在任意一分钟合计可以使用的 TPM 和 RPM 的最大百分比。
- 用户速率限制: 按模型配置任意单个用户在任意一分钟可以使用的最大 TPM 和 RPM。
View usage
View usage 标签页让你可以洞察你注册中所有项目、资源和用户对 Palantir 提供的所有模型的 LLM token 与请求用量。管理员可以使用此视图来更好地管理 LLM 容量并处理速率限制。
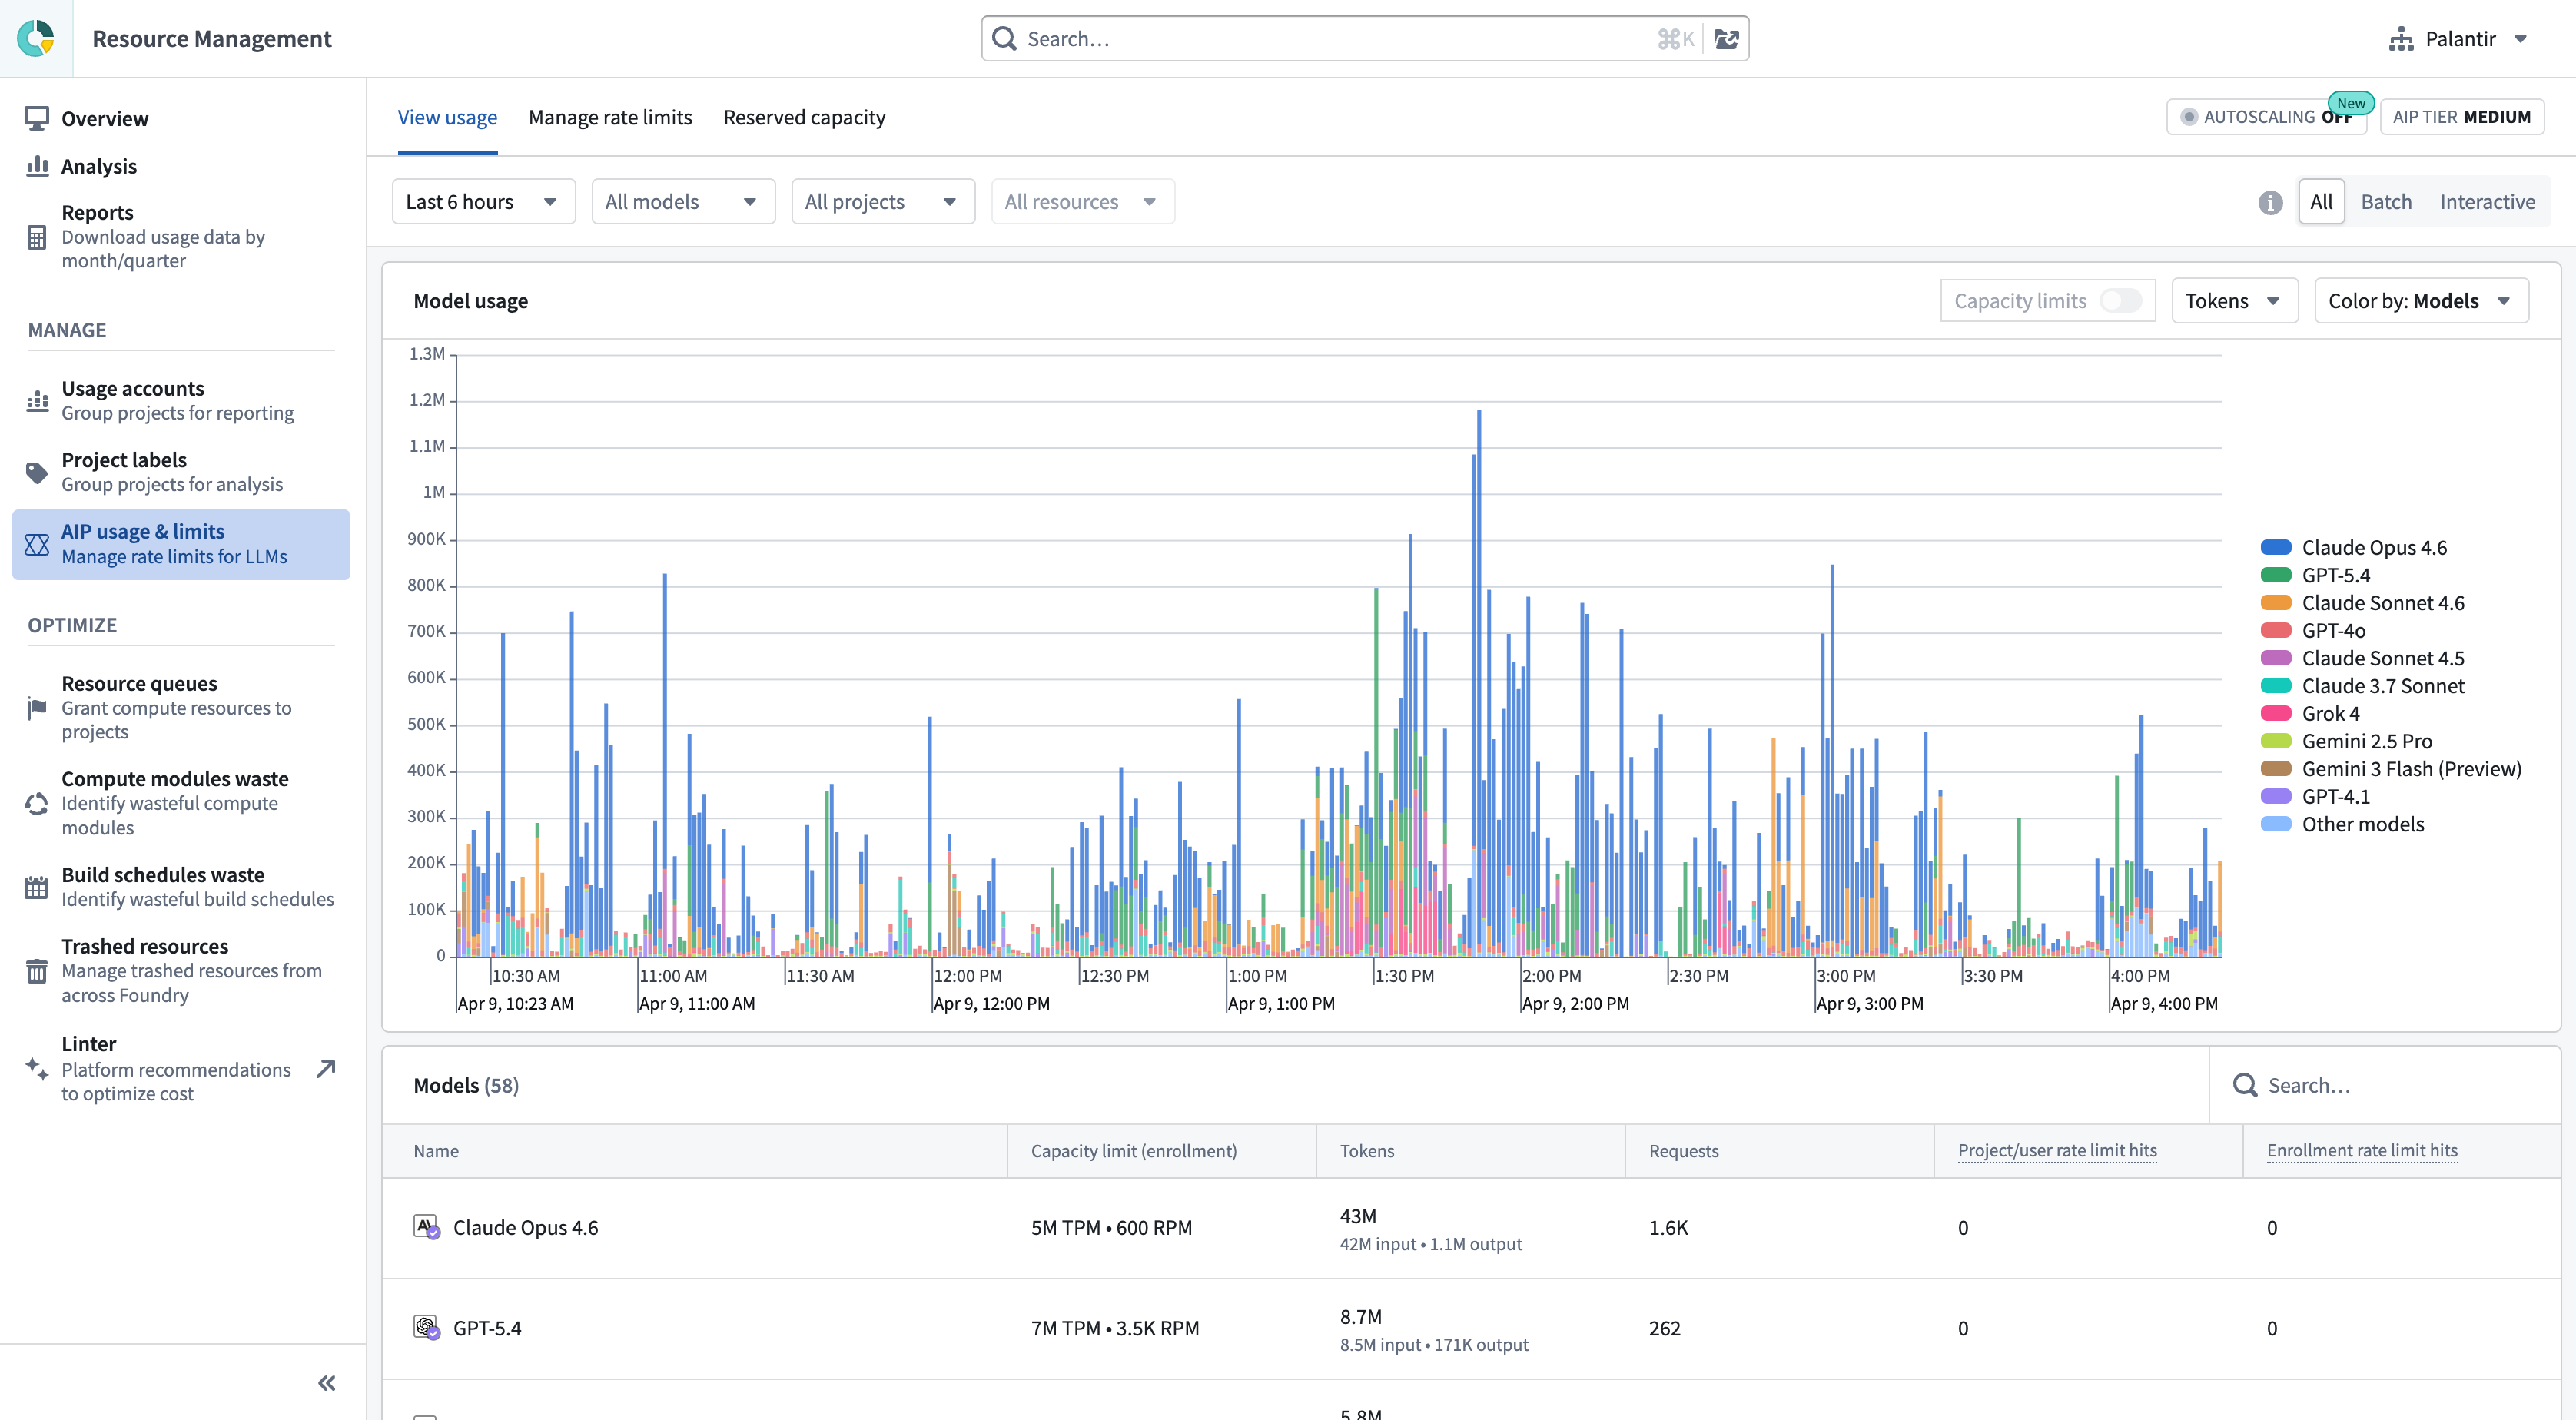
此视图让你可以:
- 查看跨所有模型的聚合用量,以及按单个模型划分的用量明细。
- 按分钟追踪 token 与请求用量,因为 LLM 容量是在每分钟 token(TPM)和每分钟请求(RPM)层级上管理的。
- 一次下钻到单个模型,因为容量是按每个模型分别管理的。
- 既查看注册用量总览,也放大到项目级用量,因为如前所述,LLM 容量既有注册级限制,也有每个项目的项目级限制。
- 查看每个模型的用户归属用量总计。
- 查看速率限制阈值。 右上角的开关会通过显示虚线来可视化何时触及项目或注册限制。限制因模型和项目而异。会显示两条速率限制线:注册/项目限制,以及「批量限制(batch limit)」——后者被限制为特定项目和整个注册总容量的 80%。可在下文进一步了解优先处理交互式查询。
- 下钻到特定时间范围,最长两周数据,最小到分钟级。用户可以通过左侧边栏的日期范围筛选器,或在图表上直接拖拽选择时间范围,来下钻到特定时间段。当时间范围短于 6 小时时,图表会包含按项目(在注册层级)或按资源(在项目层级)的分段。
- 以表格查看用量总览。 图表下方,表格包含按项目(或筛选到单个项目时按资源)聚合的 token 与请求数。表格会受所有筛选器影响(时间范围、模型、若应用了项目筛选器)。
此视图并未针对 LLM 用量的成本管理进行优化。了解如何通过 Analysis 标签页查看已启用 AIP 的注册上的 LLM 成本。
Taking action based on AIP usage
如果你在注册或项目层级触及速率限制,可以考虑采取以下任一措施:
- 调整项目限制,为可能占满你注册容量的某个资源或项目设定用量上限。
- 追踪交互式用量,确保它没有被流水线施加速率限制。如果有,你可以在项目层级限制这些流水线,或者把该资源迁移到一个限制更高的独立项目中。
- 将构建调度到一天中的不同时间,将大型构建安排在周末——尽可能避免同时运行多个大型构建,并在可能时将常规构建安排在不同时间或频率,以避免冲突。
- 将你的工作流切换到你的注册当前未使用、因而有充裕容量的另一个模型。
- 申请升级到更大的层级。
管理速率限制
LLM 请求以两种方式之一进行归属,且两者互斥——每个请求都恰好受其中一种限制类型管控:
- 项目归属的请求(Project-attributed requests) 受注册限制和相关项目限制管控。这涵盖请求源自已配置项目资源的工作流(例如 Pipeline Builder 流水线、AIP Logic、Automate、Chatbot Studio 和 Workshop 应用)。按用户限制不适用于这些请求。
- 用户归属的请求(User-attributed requests) 受注册限制和调用用户的按用户限制管控。这涵盖请求直接源自用户会话而非项目资源的工作流(例如 AI FDE、AIP Assist、AIP Analyst,Pipeline Builder Explain 和 Generate 等原生助手功能,以及连接到 Foundry 提供的模型的 Continue(VS Code)和 Claude Code 等 IDE 集成)。
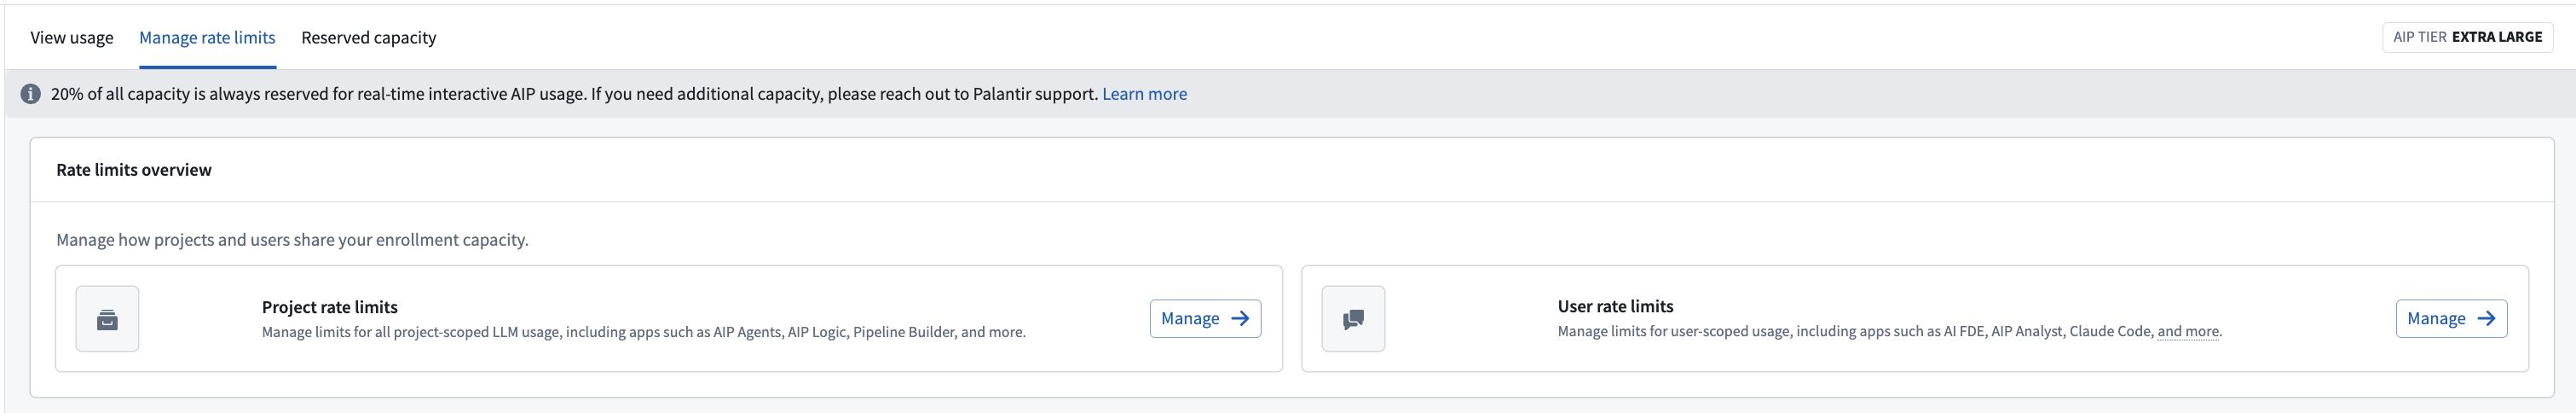
Manage project rate limits
在 Resource Management 中 AIP usage & limits 页面下的 Manage rate limits 标签页上,管理员可以灵活地为 AIP 中宏大的用例最大化生产用例的 LLM 使用,同时限制或禁止实验性项目占满整个注册容量。注册管理员可以按模型配置给定项目内所有资源在任意一分钟合计可以使用的 TPM 和 RPM 的最大百分比。
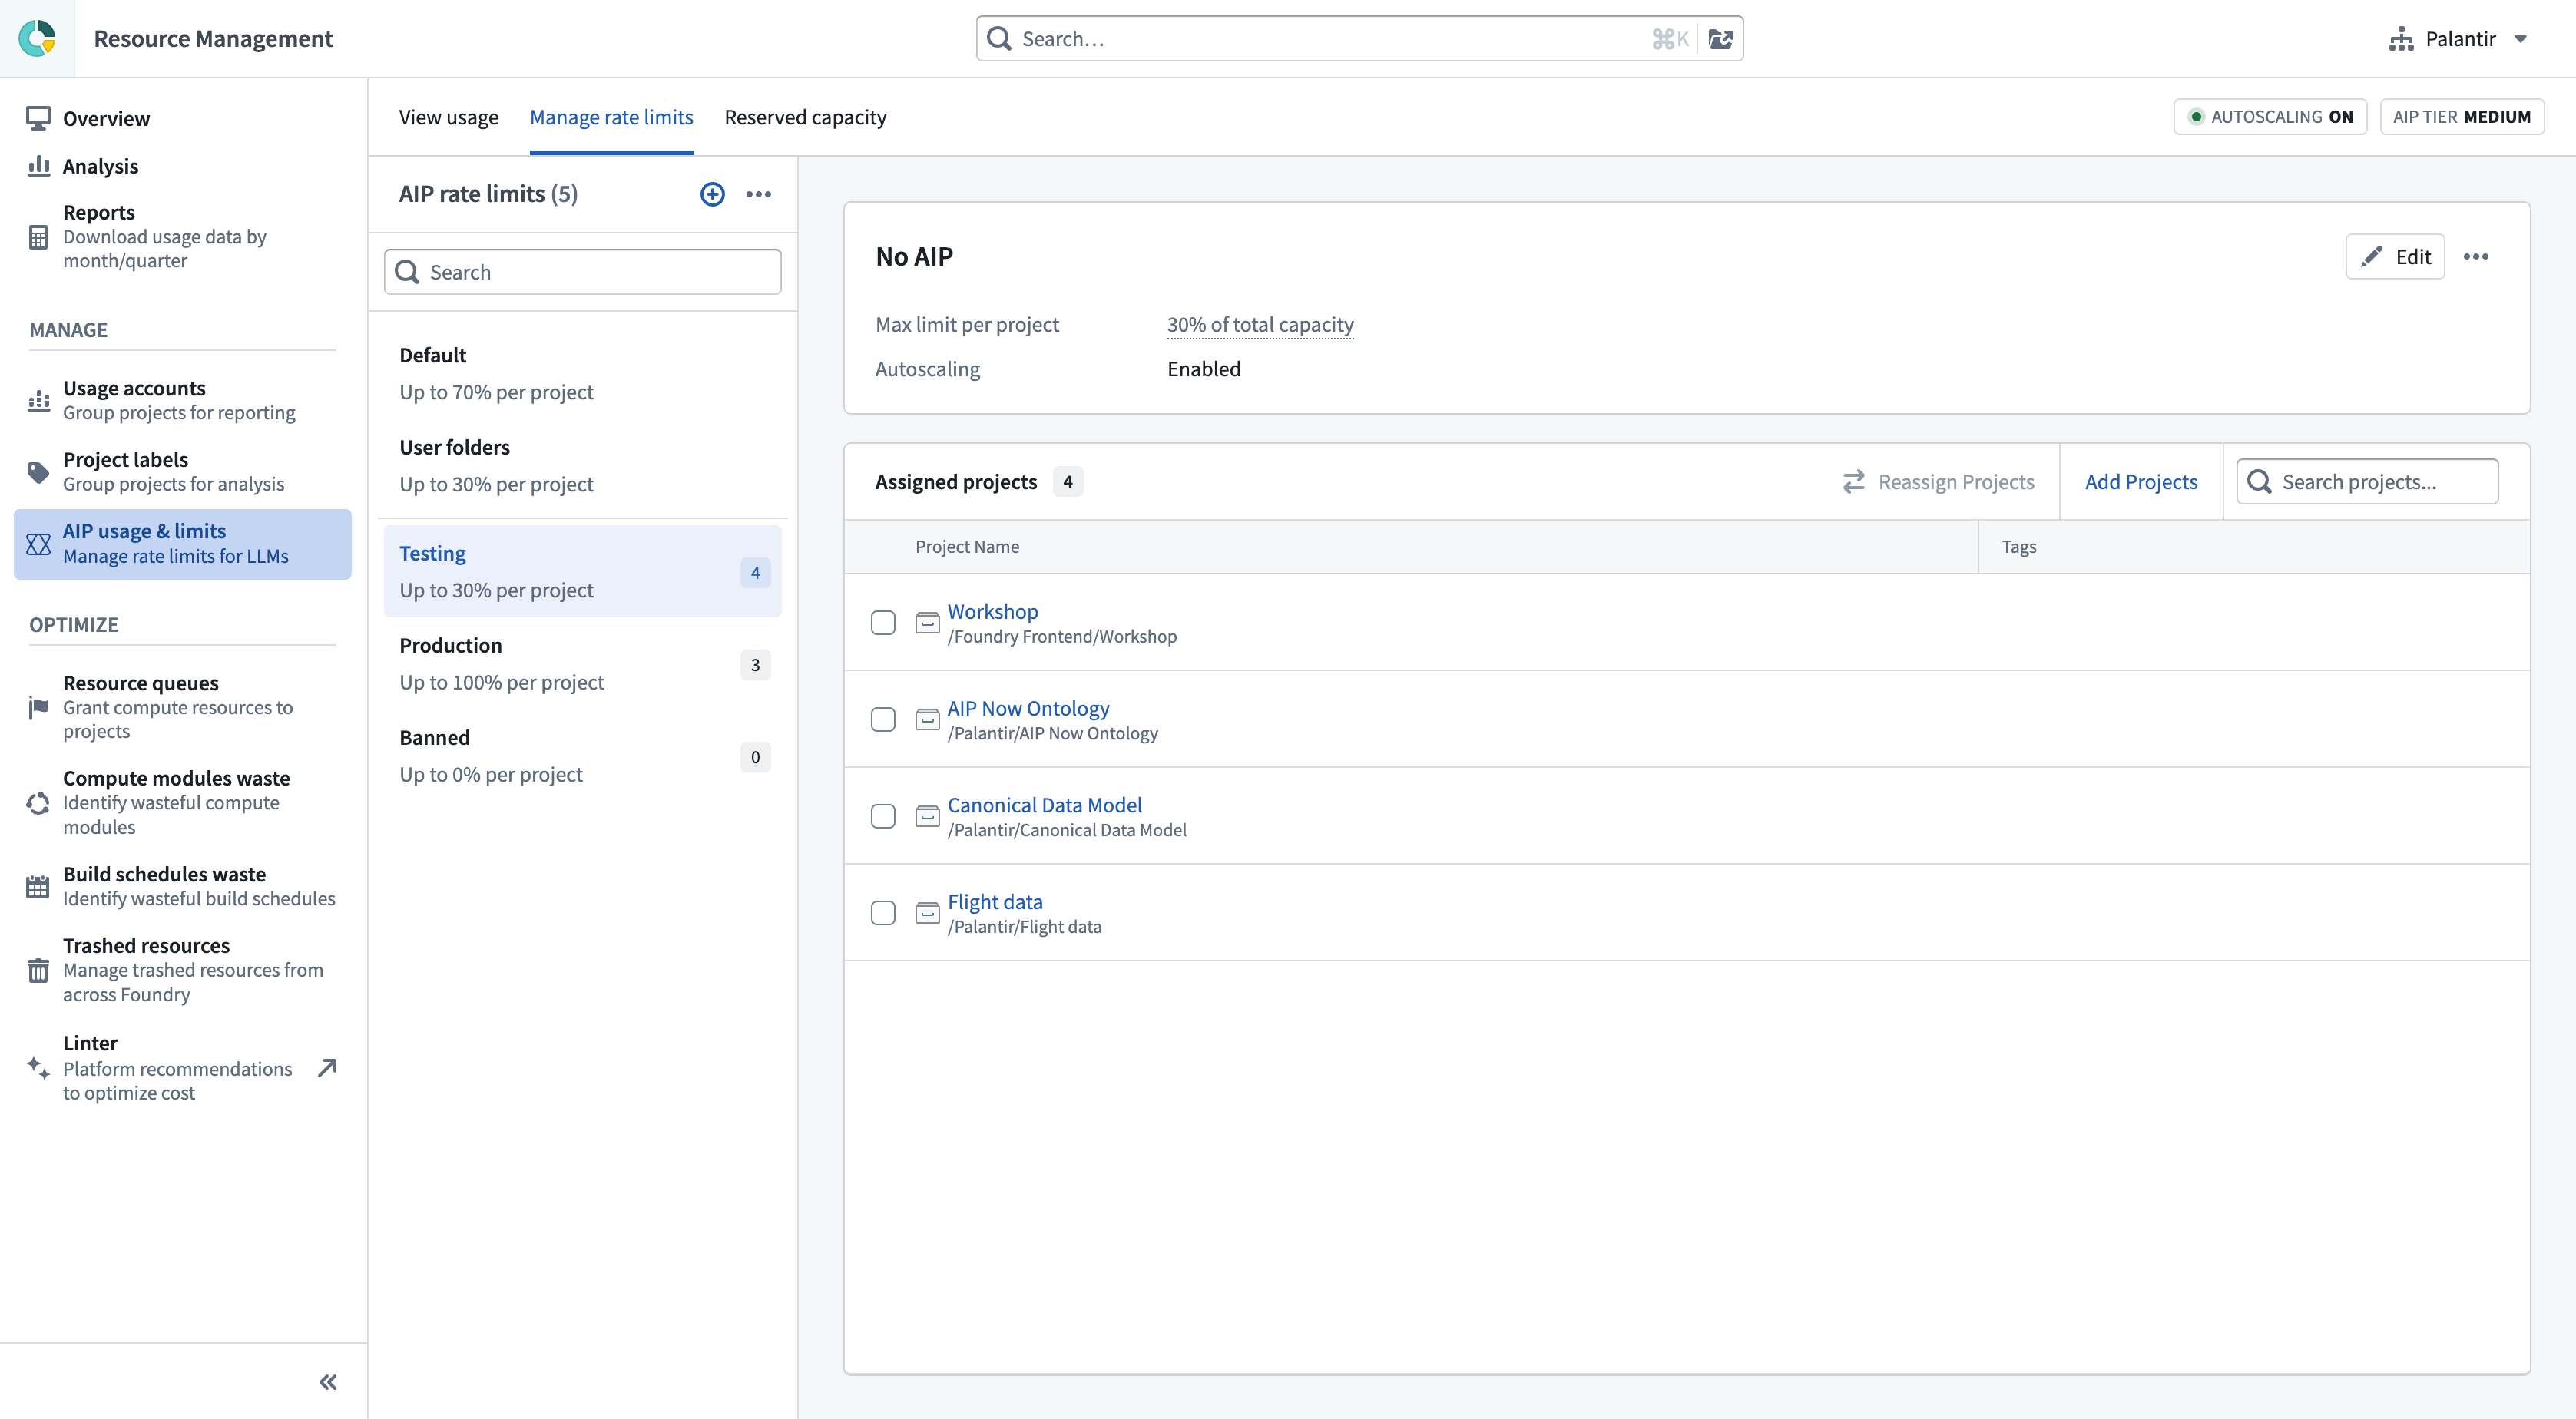
默认情况下,所有项目都会被赋予一个用于运行的特定限制。管理员可以创建额外的项目限制、定义每个限制包含哪些项目,以及可以使用注册容量的百分比。
Model overrides
在每个项目限制内,你可以配置针对特定模型的覆盖设置,以在模型层级进一步控制容量分配。模型覆盖允许你为单个模型设置不同的百分比限制,从而覆盖基础项目限制。这些覆盖仅适用于该特定项目限制所包含的项目(对于默认限制,则适用于所有未分配到其他手动创建的项目限制的项目)。
模型覆盖支持更细粒度的容量管理,并允许你创建模型「允许列表」;你可以将基础项目限制设为 0%,然后仅为已批准的模型添加带有特定百分比的模型覆盖。你也可以通过将某个模型的覆盖限制百分比设为 0% 来明确禁止该模型。
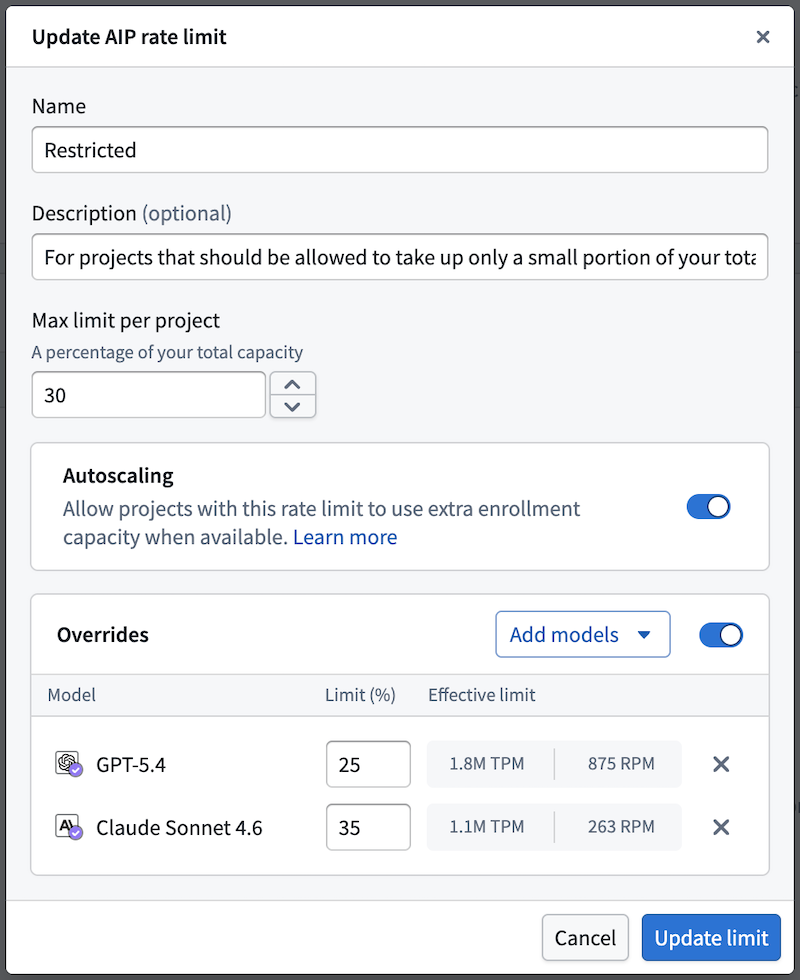
例如,以下步骤说明了如何将某个项目限制中的项目限定为只能使用 Claude Sonnet 4 和 GPT-4.1:
- 将基础项目限制设为 0%。
- 为 Claude Sonnet 4 添加一个 30% 的模型覆盖。
- 为 GPT-4.1 添加一个 25% 的模型覆盖。
该一项目限制中所有项目里的用户将只能在其分配到的容量限制内访问指定的模型。
User rate limits
按用户速率限制管控单个用户可用于用户归属请求的容量。它们确保没有任何单个用户能够通过交互式工作流耗尽注册中某个模型的全部容量。
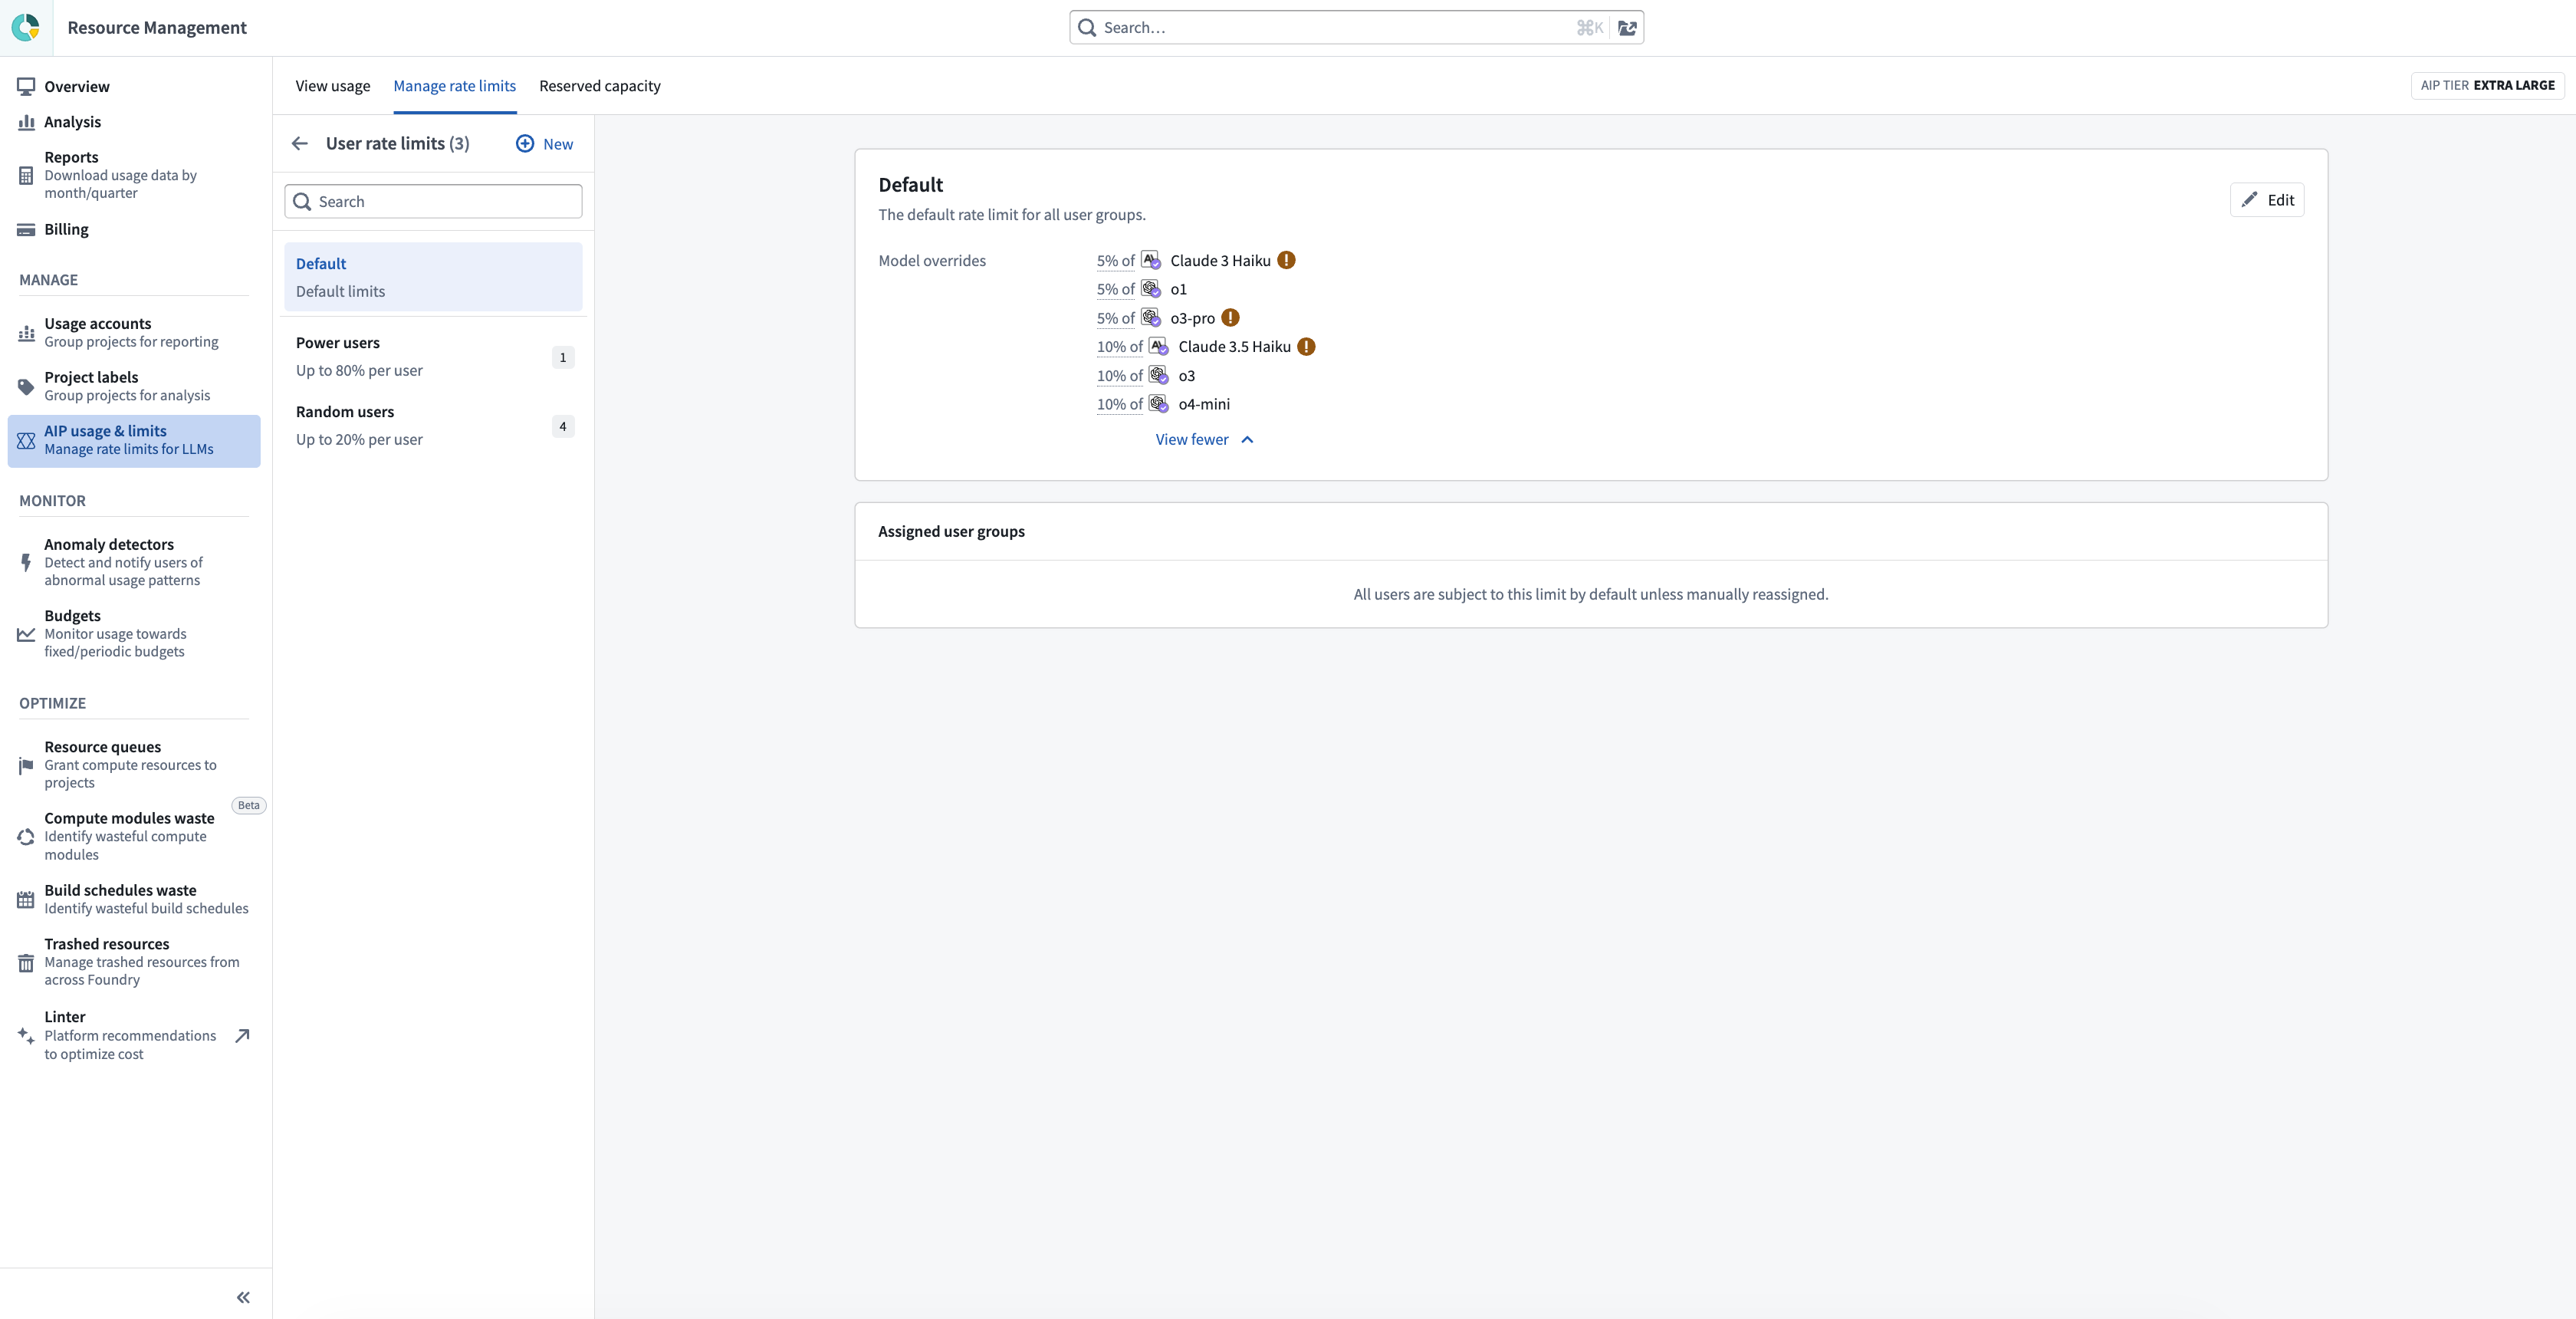
用户速率限制在 Resource Management 中 AIP usage & limits 页面下的 Manage rate limits 标签页上管理。注册管理员可以查看默认的按用户限制、创建用户组覆盖,以及配置按模型的覆盖。
Default per-user limits
每个模型的默认按用户限制显示在 Resource Management 的 User rate limits 标签页中,或注册速率限制表的 Per-user Limits 列中。这些默认值由 Palantir 设定,适用于所有用户,除非被管理员在 User rate limits 标签页中覆盖。 每个模型的默认按用户限制显示在 Resource Management 的 user rate limits 标签页中,或注册速率限制表的 Per-user Limits 列中。这些默认值由 Palantir 设定,适用于所有用户,除非被管理员在 user rate limits 标签页中覆盖。
我们建议使用 Palantir 的默认用户速率限制。我们定义这些默认值是为了平衡以下两点:(a)保护注册限制不被单个用户占满;(b)使用户能够高效使用 Foundry 中最新的 AIP 工具,最大化其生产力。如果管理员选择为所有模型设置新的自定义限制,那么在新模型发布时应重新审视该限制,以确保不会无意中限制了自己的用户。
Per-user overrides
注册管理员可以覆盖按用户默认值,为特定用户(作为特定用户组的一部分)授予不同的按用户限制。这对于高级用户、交互式应用背后的服务账户,或用户归属工作流需要持续高吞吐的团队很有用,且无需提高注册的整体容量层级。它也是一种工具,可以保护生产工作流中使用的某个模型的容量,避免被用户意外占满。
按用户覆盖可以用以下两种方式之一表示:
- 注册限制的百分比: 介于 1 到 100 之间的值,表示注册级速率限制的百分比。例如,如果某个注册为某个模型设有 400 万 TPM,而管理员配置了 25% 的覆盖,那么该覆盖涵盖的每个用户都会获得 100 万 TPM 的有效限制。
- 绝对 TPM 和 RPM 值: 显式的每分钟 token 数和每分钟请求数。当基于百分比的方式不符合所需限制时,这为管理员提供了精确的控制。
配置覆盖后,它会取代已发布的按用户默认值;它不会与默认值混合,也不会以默认值为下限。
为某个模型设置低于 50,000 TPM 或 10 RPM 的按用户限制,可能会破坏受影响用户的某些 AIP 功能。当配置的限制低于这些建议最低值时,覆盖表单会显示警告。
Levels of override
按用户覆盖可以在三个层级上配置,按具体程度依次应用:
- 默认按用户覆盖: 一个适用于注册中每个用户、跨所有模型的单一百分比。它会成为新的基线,取代 Palantir 已发布的按模型默认值。
- 按模型覆盖: 在默认值之上,为一个或多个特定模型设置不同的百分比或绝对限制。按模型覆盖允许管理员提高或降低单个模型的按用户限制,而无需在整个目录范围内更改。
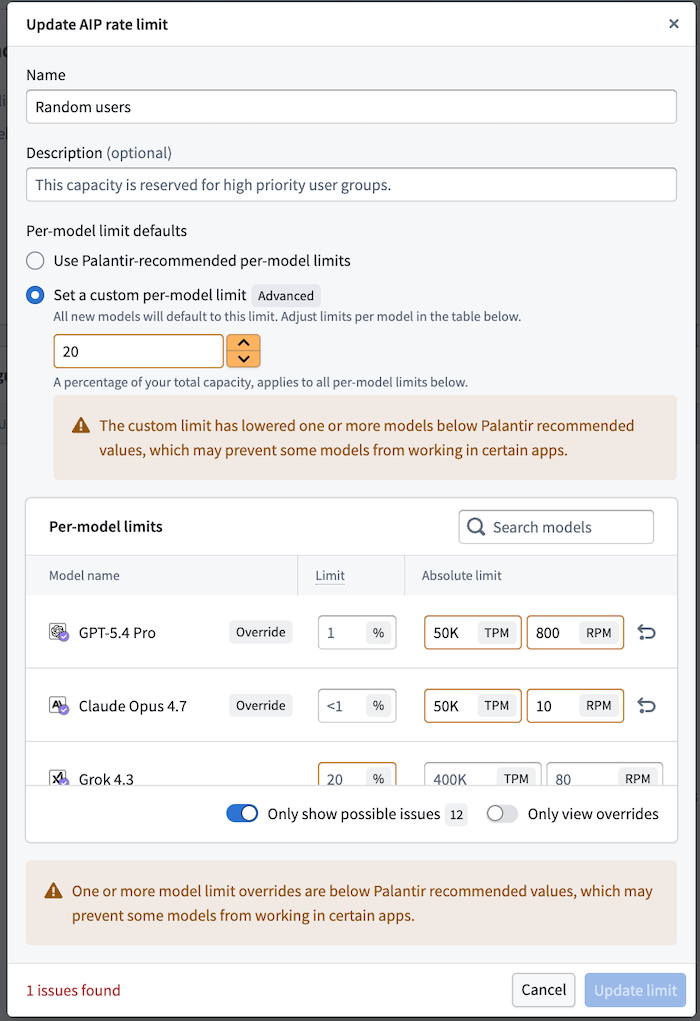
- 用户组覆盖: 针对一个或多个 Foundry 用户组的覆盖。用户组覆盖定义自己的默认百分比,并可选地定义自己的按模型覆盖(百分比或绝对值)。当某个用户属于被某个覆盖涵盖的组时,将使用该组的配置,而非注册范围内的按用户默认值。
如果任何层级都未配置覆盖,则使用该模型已发布的按用户默认值。
How user-group overrides resolve
用户组覆盖适用于一组具名的 Foundry 用户组。每个覆盖都有一个名称、一个可选描述、一个可选默认百分比,以及一组可选的按模型限制。当某个用户属于该覆盖中列出的任何一个组时,就会与该覆盖匹配。
如果某个用户属于被多个覆盖涵盖的组,则对该用户和该模型而言,这些覆盖中产生的最高的限制胜出。这使覆盖具有可加性和可预测性:通过某个组授予用户更高的限制,不会因为该用户同时属于另一个配置较低的组而被悄然取消。例如,假设某个注册的默认用户限制为 40%。用户 A 属于两个不同的用户限制覆盖下的两个组,其中一个将用户限制定义为 10%,另一个定义为注册容量的 35%。用户 A 将拥有 35% 的用户限制,即这些覆盖中最高的那个。
当某个用户组覆盖被移除时,受影响组的成员会回退到注册范围内的按用户配置。如果该注册自身没有按用户配置,则回退到已发布的按用户默认值。
AIP reserved capacity
预留容量(Reserved capacity)是 Resource Management 中的一款 AIP LLM 容量管理工具。预留容量保证为某个模型保留一定份额的每分钟 token(TPM)和每分钟请求(RPM)。请将其用于关键的生产工作流,这些工作流绝不能因项目速率限制、注册限制或其他资源对同一资源池的争用而被降速。
Key features
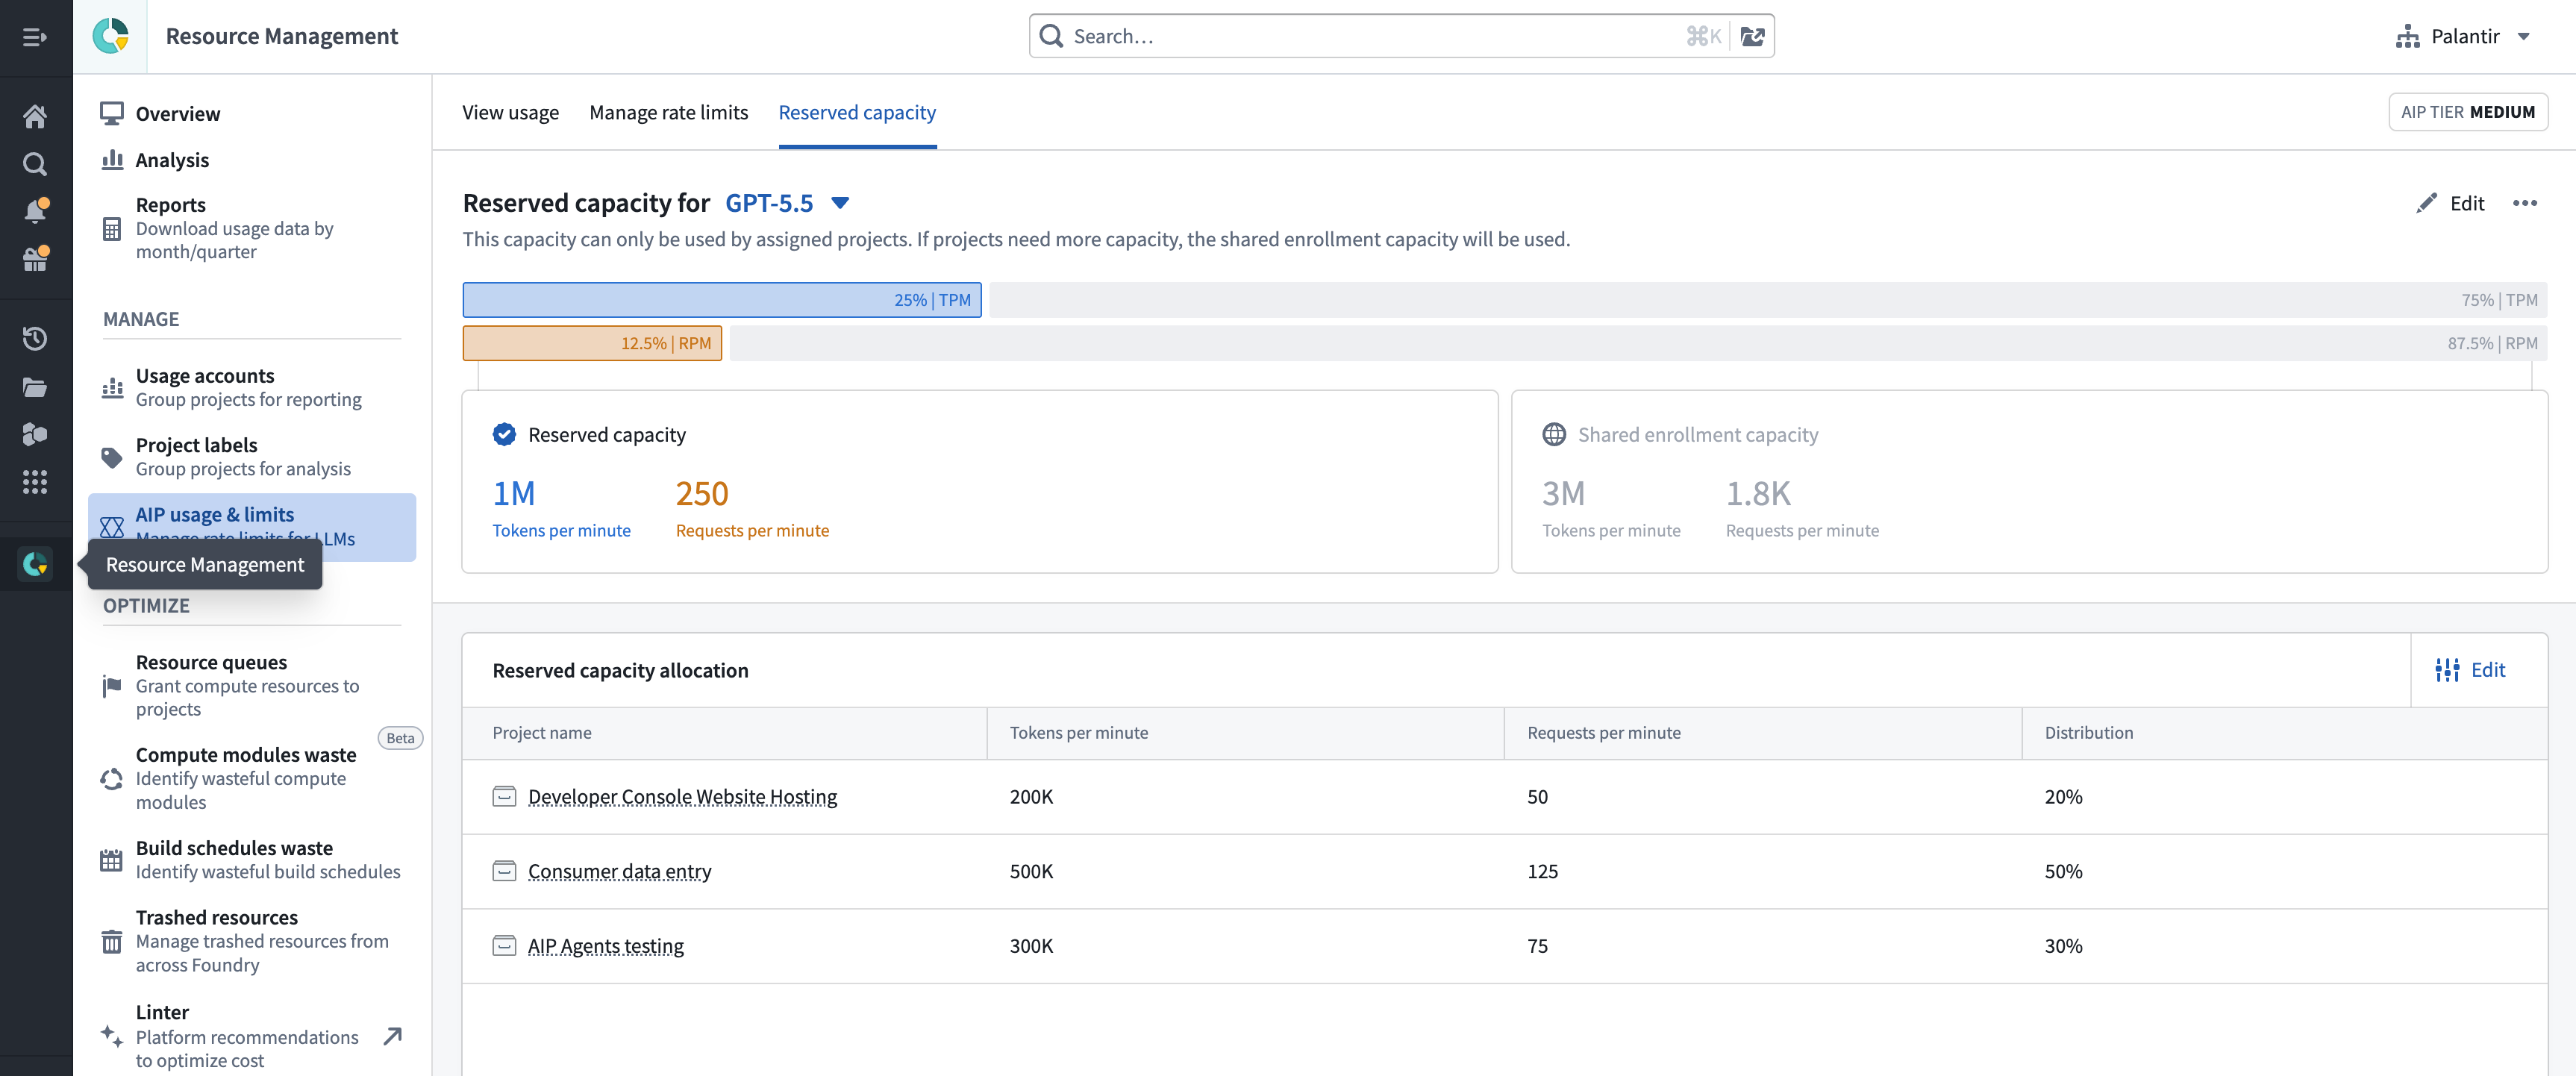
- 预留容量在模型层级配置,从该模型可用的总容量中预留特定数量的 TPM 和 RPM。
- 可以为项目分配总预留容量的某个百分比,让你能够优先保障最关键资源的容量,并自定义 LLM 分配以符合你的组织需求。
- 当预留容量用尽时,被分配到该项目会自动回退到由现有项目和注册限制所管控的共享容量。
Availability and costs
预留容量适用于所有模型。你最多可以预留某个模型总容量的 50%。如果总容量之后下降,你的预留量会得到保留,最多为新的总容量的 95%。
根据 AIP 过去一年的表现,预留容量足以实现 99.9% 的正常运行时间。我们无法保证 100% 的容量可用性,但根据过去一年的使用模式,超过 99% 的 LLM 请求失败是由注册和项目速率限制导致的。这些问题可以通过预留容量工具来解决和处理。
作为一项服务,预留容量不额外收费;额外费用将取决于额外的 token 用量,与 AIP 中所有其他 LLM 用法一样。这一点在未来可能会因新用例或特定模型而发生变化。如果此政策变更,我们不会针对使用预留容量对现有工作流进行追溯收费;这些工作流将继续仅根据额外的 token 用量产生费用。
拥有 resource management administrator 权限的用户可以为某个模型预留容量,并将其分配到特定项目。
Example usage
考虑以下示例,以进一步理解预留容量的用法:
- 你的注册为某个模型拥有 100 万 TPM 的容量。对于一个包含生产应用的项目,该应用的默认限制为注册容量的 70%,即 70 万 TPM。
- 要提升这个生产应用的容量,你可以通过提高项目速率限制,将所属项目的容量增加到注册容量的 100%,即 100 万 TPM。
- 尽管该应用的限制现在为注册限制的 100%,但这个应用仍在与其他资源争夺这份共享容量。你可以在 Resource Management 应用的 AIP usage & limits 部分的 View usage 标签页中识别出竞争资源。然后,你可以调整竞争资源的调度时间,或将资源迁移到不同的模型上。
- 为确保这个生产应用即便是在你优化了调度和模型使用之后仍能获得所需容量,你可以使用预留容量。假设你从可用的 100 万 TPM 中预留 25 万 TPM,剩下 75 万 TPM 作为共享容量。
- 你可以将这部分预留容量分配给关键资源,例如你的生产应用。该应用会先使用其预留的 25 万 TPM。在该容量用尽后,它会使用 75 万 TPM 的共享容量,并在其中与其他资源竞争。注册总量仍为 100 万 TPM:25 万 TPM 专为该应用预留,其余 75 万 TPM 在所有资源之间共享。
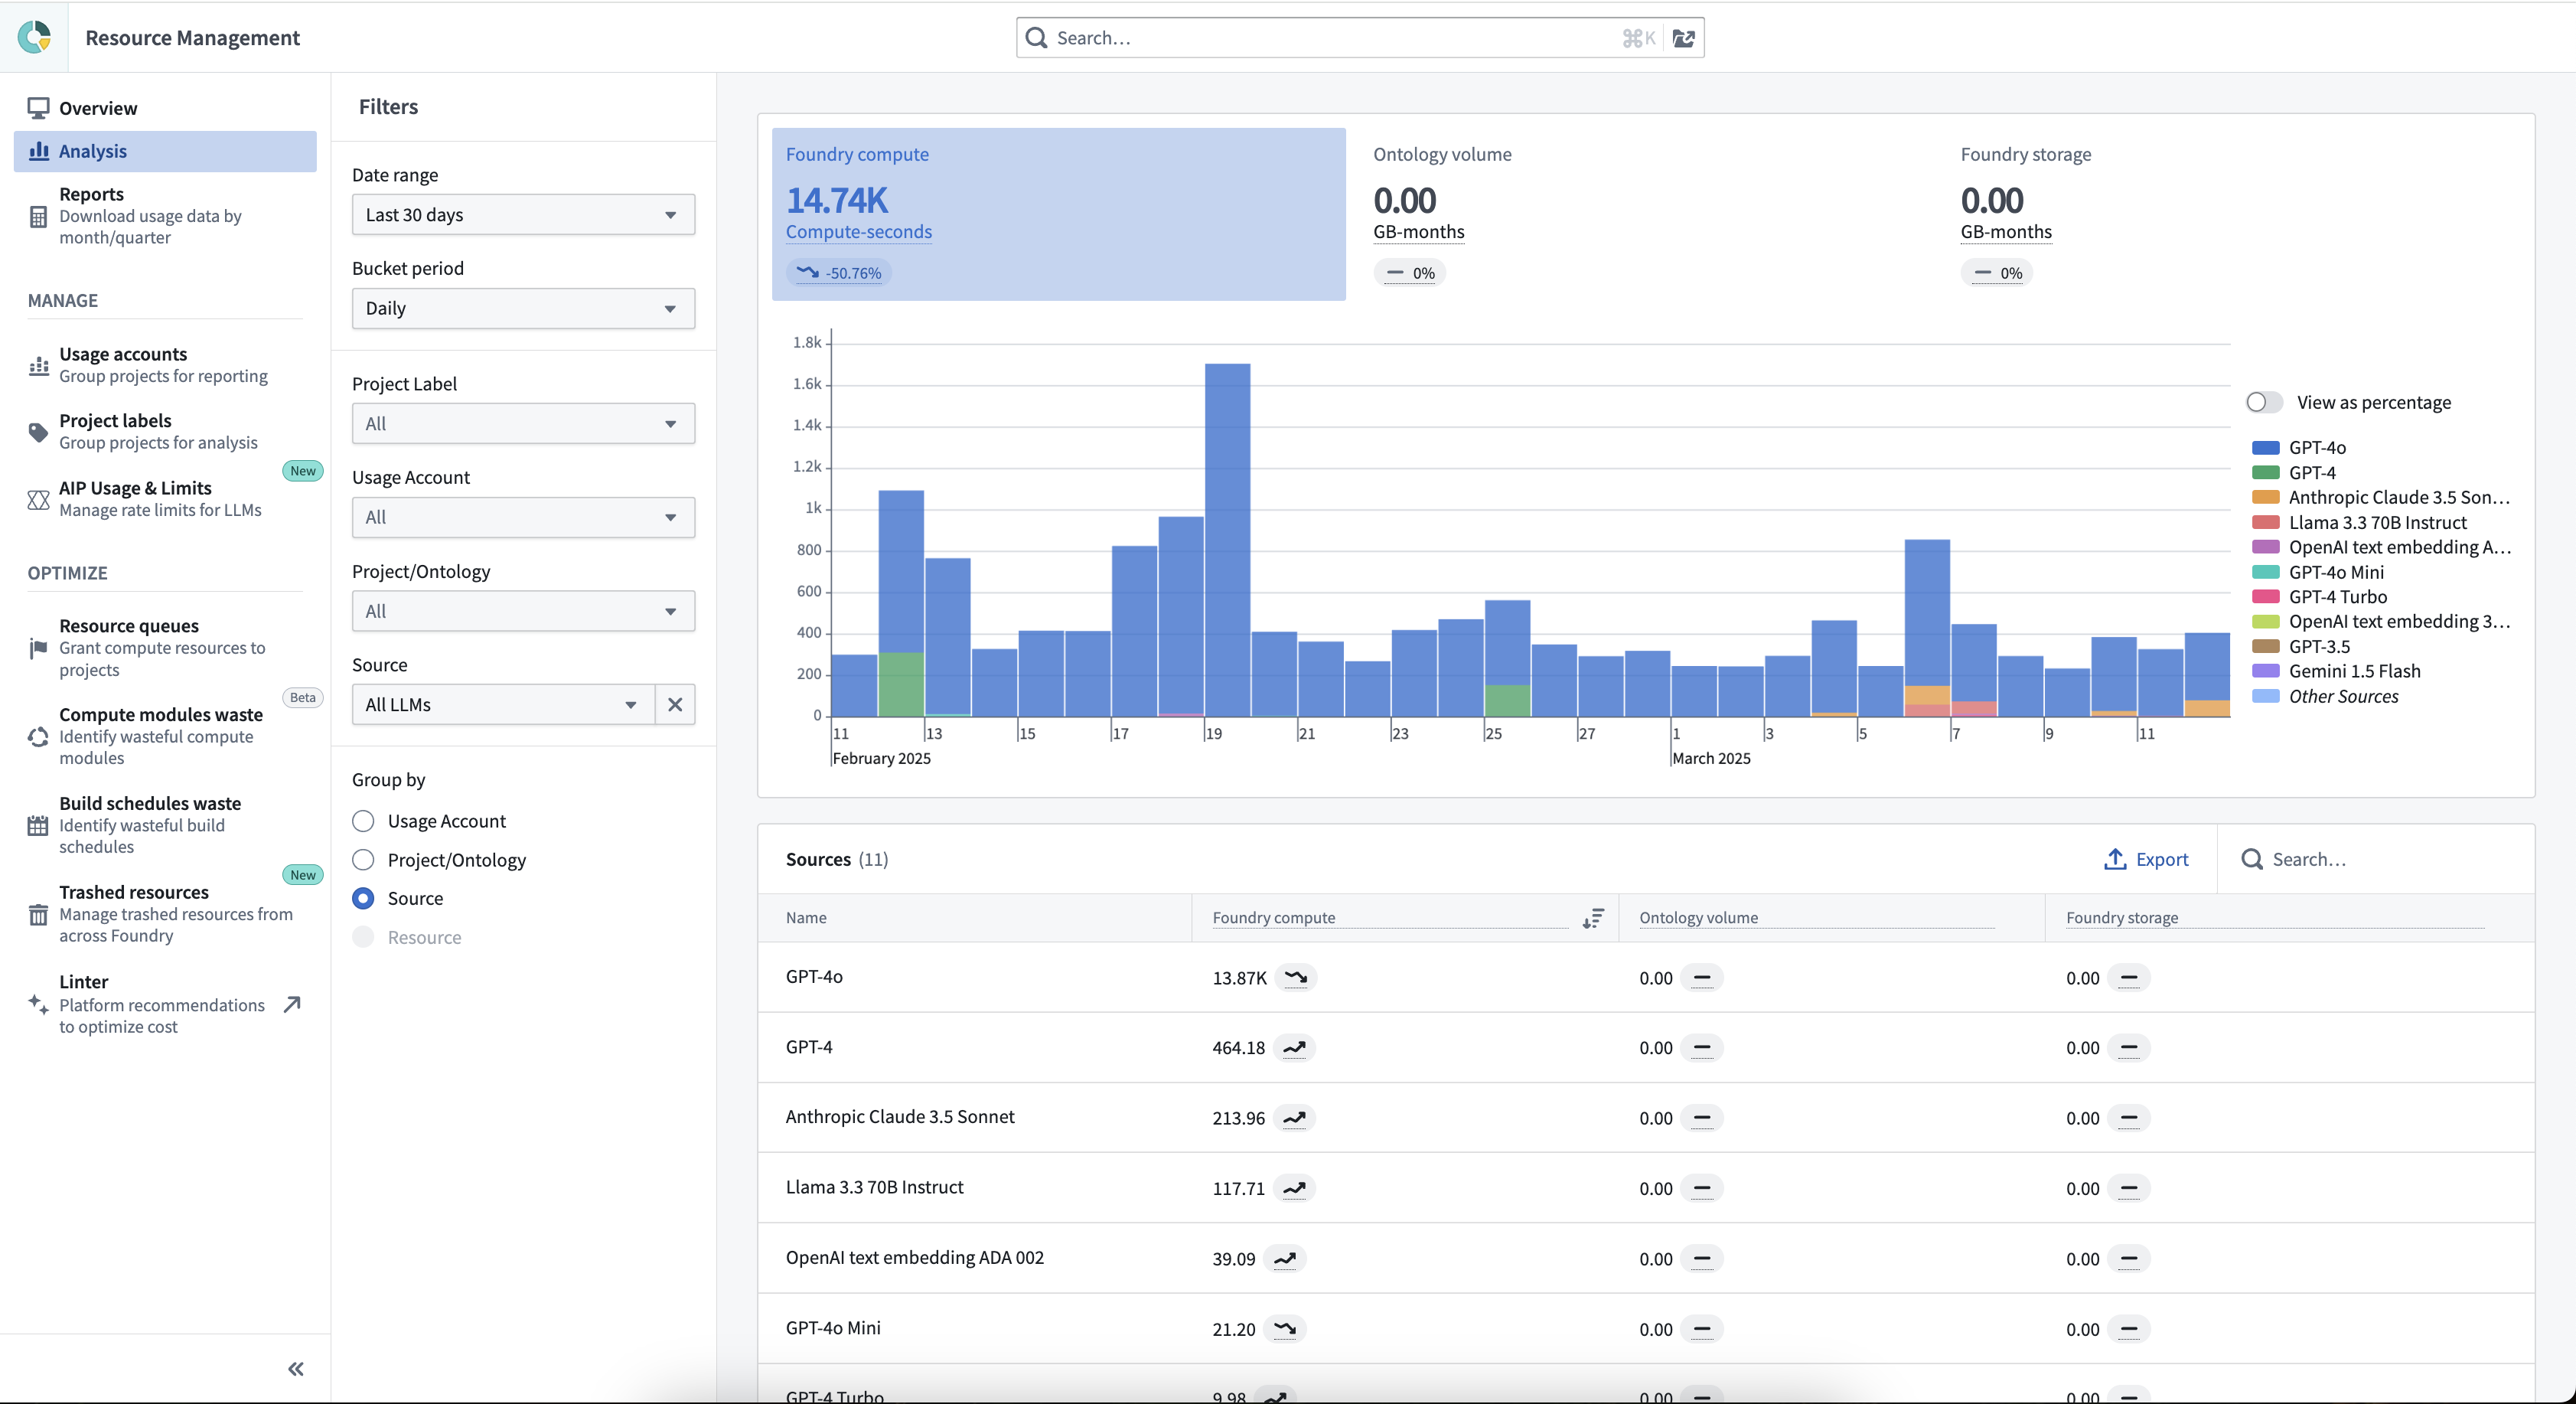
查看注册下的 LLM 成本
使用 Analysis 页面查看你已启用 AIP 的注册上的 LLM 使用成本。
在 Analysis 页面中,选择 Filter by source: All LLMs 和 Group by source。这将生成一张按模型分段的每日 LLM 成本图表。
交互式查询的优先级
通常,AIP 会优先处理交互式请求,而非带有批量请求的流水线。交互式查询定义为用户与 LLM 的任何实时交互,例如 Workshop、Chatbot Studio、AIP Logic LLM board 中的预览,以及 Pipeline Builder LLM 节点中的预览。批量查询定义为在用户不期望立即响应的情况下发送的大量请求,例如 Transforms 流水线、Pipeline Builder、Automate(用于 Logic)。
此原则目前保证在注册和项目层级始终为交互式查询预留 20% 的容量。这意味着对于某个模型 100,000 TPM 的容量,在任意给定分钟,最多只能有 80,000 TPM 用于流水线,而至少有 20,000 TPM(最多可达 100,000 TPM)可用于交互式查询。
常见问题
What is an example of how project-level and user-level rate limits are expected to be used?
考虑以下示例:
- 某个注册在生产环境中只有一个 AIP 用例,因此包含该用例的项目被移到「Production」限制之下,以访问最多 100% 的注册限制。
- 除了这个生产用例之外,还有一个处于测试阶段的第二用例需要考虑。这个测试阶段的用例应该能够运行测试,而不会占用整个生产用量。可以将这个用例加入一个「Testing」限制,最多可用 30% 的容量。「Production」限制则降低到 90%,以确保始终有一些容量可用于测试。
- 在上述用例之外,我们在生产中增加第二个用例。然而,与第一个使用 GPT-5 的用例不同,这个用例使用 Claude Sonnet 4.6。我们可以安全地将这个新用例加入「Production」限制,与第一个生产用例并列。
- 同一个注册希望让一组用户能够试验 LLM。注册管理员将两个项目加入一个「Experimentation」限制,最多可用 20% 的容量。
- 从技术上讲,测试项目和这两个实验项目合计最多可以消耗 70% 的容量,但历史数据表明实际用量通常低于此值。
- 最后,这个注册希望保护其生产用例不被单个用户占用。管理员为 GPT-5 和 Claude Sonnet 4.6 设置覆盖,将默认用户速率限制改为注册容量的 10%,同时提高 Claude Opus 4.6 和 GPT-5.4 的容量。此外,他们将用户主文件夹的容量设为 0%(以抑制在私有文件夹中构建、鼓励协作),并在 Control Panel AIP 设置中为这些指定用户授予 LLM builder 权限。
Why is the percent enforced on each project in a limit category rather than shared across projects and users?
- 多个项目和资源之所以可以共享同一个 100% 容量,是因为基于过去一年多来数百家客户的历史 LLM 使用模式,大多数项目和资源并不会调用 LLM。因此,多个资源可以共享同一个 100% 容量。
- 如果某个限制类别中的所有项目都共享同一使用百分比,那就会实施用量的硬性上限。然而,基于现有使用情况,这对 99.9% 的情况来说都不合理。多个资源在同一分钟使用最大容量的情况非常罕见,即使发生,请求也会重试直到成功。
Why are there AIP usage limits?
- 首先,不同提供商在 TPM、RPM 和区域可用性方面的供给存在显著差异。虽然 AIP 确实利用了所有提供商的容量,但 Palantir 无法绕开各个云服务提供商施加的限制。
- 除此之外,与大多数提供商的常见供给相比,Palantir 提供给客户的 LLM 容量具有更高的合规要求门槛。Palantir 保证零数据留存(ZDR)以及对数据路由到特定区域的控制(地理限制)。
- 大多数提供商,即 Azure OpenAI、AWS Bedrock、GCP Vertex 和 Palantir 托管的模型,都支持地理限制,但对于地理受限的请求,它们能保证的 LLM 容量也更小。其他提供商,例如 OpenAI direct、Anthropic direct 和 xAI,则在较少的地区提供其模型。
- 客户在 Control Panel 的 AIP Settings 下启用的模型提供商越多,所获得的容量就越高。
- 我们为用量水平更高的客户提供升级到容量更大的更大层级的选项。
- 没有地理限制的 AIP 客户可以使用更大的容量池。
- 某些模型在某些地区仍未广泛可用。有时 Palantir 能提前获得它们,但这并非总能做到。
- 某些能力仍然不可用,例如批量 API。批量 API 支持在 24 小时内处理数十亿 token,但需要在此期间存储数据,这不符合 Palantir 的合规要求。
- 如上所述,我们的 medium 到 XL 层级对于大规模生产工作流已经足够。请联系 Palantir 支持以更改你的层级。
What are the biggest obstacles to solving the capacity problem?
- 地理限制是容量问题最强的成因。如果你的注册受地理限制,而你在法律层面能够移除地理限制,你应当与你的 Palantir 团队合作来完成这一点。
- 新模型在早期阶段通常容量有限。
- 对于运行在数百万乃至数千万条目上的大型流水线,容量问题要困难得多。
延伸阅读 · 相关页面
按主题横向跳转,不必顺着目录一篇篇读。
本组其他页面 · 核心平台(AIP 总览与治理)
同一主题下的相邻内容。
- AIP 总览:把 AI 接进你的数据与运营AIP(Artificial Intelligence Platform)不是孤立的模型平台,它长在你的数据与 Onto
- AIP 能力清单:平台各处的 AI 特性平台里几乎每个应用都配备了 AIP 驱动能力。这一篇把它们按应用分类列全,作为你的能力索引表。
- 开始使用 AIP:学习路径这一篇很短,只回答一个问题:该按什么顺序学 AIP。
- 提示词工程最佳实践写提示词(prompt)这件事,直接决定 LLM 输出的质量。这一篇讲怎么写出稳定可靠的提示词,是所有 AI 应用的基本
- 平台支持的 LLM 清单AIP 支持来自 xAI、OpenAI、Anthropic、Meta、Google 等提供商的多种 LLM 与文本嵌入模
- 兼容各提供商的原生 API 端点Foundry 为主流 LLM 提供商提供代理端点,按各提供商原生 API 的格式接收请求 —— 你可以继续用熟悉的开源
- AI 伦理与治理Palantir 把负责任 AI 当作构建方式本身,而不是事后补丁。这一篇讲他们的伦理原则与治理机制。
- AIP 的安全与隐私把 AI 接进企业数据,安全是第一道门槛。这一篇讲 AIP 如何保护客户数据的隐私与安全。
- AIP 的计算用量与计费LLM 按 token 计费:输入文本和输出文本都要算钱。这一篇讲清用量从哪来、怎么算、怎么控。
- Ontology 与 AIP 的可观测性AI 跑出问题了,怎么查?这一篇讲 Workflow Lineage 里的一组能力,让你看清每条 AI 流程的来龙去脉。
- 管理员:开启 AIP 能力AIP 能力默认可能并未全部开启。这一篇是管理员的操作指南:在哪些界面、按什么顺序把能力开出来。
- 管理员:LLM 注册速率限制这一篇是纯数值参照表:各注册层级在商业环境与政府环境下的 TPM(每分钟 token 数)与 RPM(每分钟请求数)上限
常见问题速答 · FAQ
关于「管理员:LLM 容量管理」,读者最常问的几个问题。