文档智能核心概念
搞清传统抽取与 LLM 驱动抽取的本质区别,才能选对策略。这一篇把概念讲透。
https://www.palantir.com/docs/foundry/document-intelligence/core-concepts/
原始标题:AIP Document Intelligence • Core concepts • Palantir · 所属:AIP Document Intelligence(读懂文档)
先记住这几条
写在前面
传统抽取
传统抽取配置基于并非由大语言模型支撑的算法,例如 PDF 元数据抽取、光学字符识别(OCR)检测以及布局检测。AIP Document Intelligence 中的这些配置由 transform media item 端点支撑。
预处理
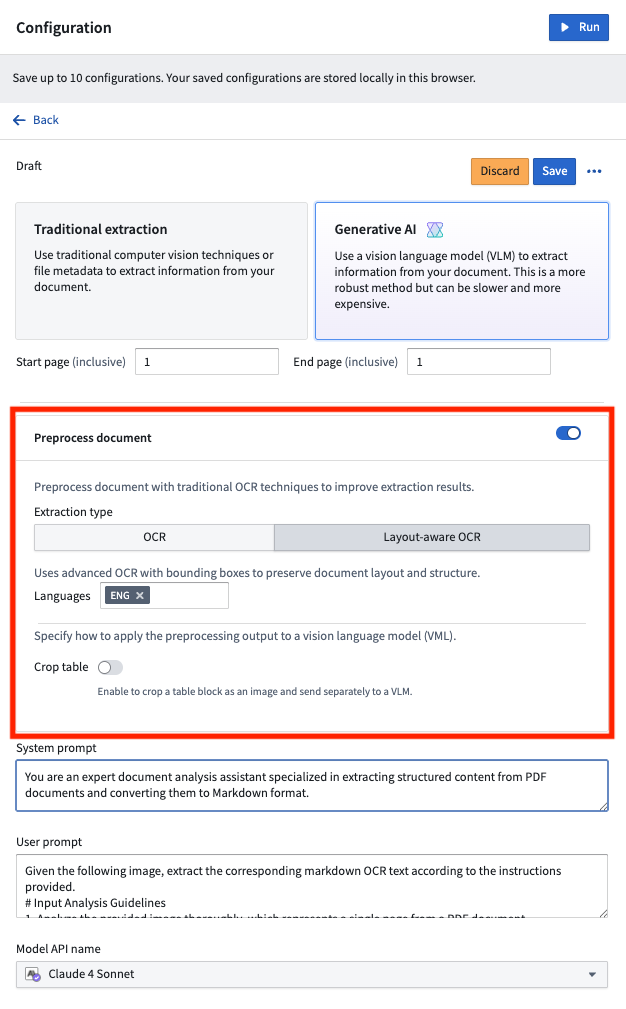
对于需要处理更复杂文档的用例,将 VLM 与预处理技术相结合已被证明相当成功。在 Configuration > Generative AI 下,打开 Preprocess document 开关。文档预处理本质上是在文档上运行传统 OCR(光学字符识别),然后将该输出连同文档页面本身一起传给 VLM,从而为模型提供更多上下文,以便成功分析文档。
评测
目前,只有当你的注册(enrollment)可使用 Anthropic Claude 4 Sonnet 时,才能执行抽取评估。
对于抽取策略的每次运行,你可以选择查看一份定性评分表(rubric),它会利用你所选的 VLM 作为评判者。我们对提示词进行了微调,使其针对多种维度从 1(最差)到 5(最佳)进行排名,包括给定策略对表格、标题等的抽取效果如何。评估让你能够在测试不同提示词和策略时快速迭代并做出判断。
部署路径
当你对某个特定策略满意后,可以将其部署到批处理管道中,以便在更大范围的数据集上运行;也可以部署为逐页抽取的 Python functions。逐页 function 让你能够构建自己的抽取工作流,按用例所需的结构化方式消费 Ontology(本体)。
Python transform
你可以将策略导出为 Python transform 仓库模板,该模板完全动态化;数据集 RID/路径、模型 RID/路径、自定义提示词以及所选配置都会自动配置好。我们建议你在触发构建前先验证这项工作。
Python functions
按照平台内的指南并利用生成的代码片段,使用你的抽取策略搭建一个 Python functions 仓库。这些 functions 一次抽取一页。结合 Automate 等工具使用你自己的编排策略,以配合你的 Ontology 定制此工作流。
延伸阅读 · 相关页面
按主题横向跳转,不必顺着目录一篇篇读。
本组其他页面 · AIP Document Intelligence(读懂文档)
同一主题下的相邻内容。
- AIP Document Intelligence 总览企业里大量信息锁在文档里。AIP Document Intelligence 是 Foundry 中文档抽取的统一入口:
- 把抽取策略部署到 Python transform验证好的策略可以部署成 Python transform,对媒体集里所有文档的所有页面跑批量抽取 —— 这是从"试验"到
- 把抽取策略部署到 Python 函数如果需要按需、单次抽取(而不是批量跑),部署成函数更合适。这篇给出操作路径与生成的代码。
- 文档转文本(Document-to-text)变换这是底层能力:把多种格式的文档转成文本,并且保留版面结构(段落、标题、表格)。抽取质量的上限由它决定。
常见问题速答 · FAQ
关于「文档智能核心概念」,读者最常问的几个问题。