创建评估套件
评估套件 = 测试用例 + 目标函数 + 评估函数。这篇讲怎么把它搭起来,包括同时测多个目标函数的做法。
https://www.palantir.com/docs/foundry/aip-evals/create-suite/
原始标题:AIP Evals • Create an evaluation suite • Palantir · 所属:AIP Evals(给 AI 做测试)
先记住这几条
写在前面
评估套件是用于对目标函数表现进行基准测试的测试用例与评估函数的集合。运行评估套件将对每个测试用例执行目标函数,并使用与该套件关联的评估方法。
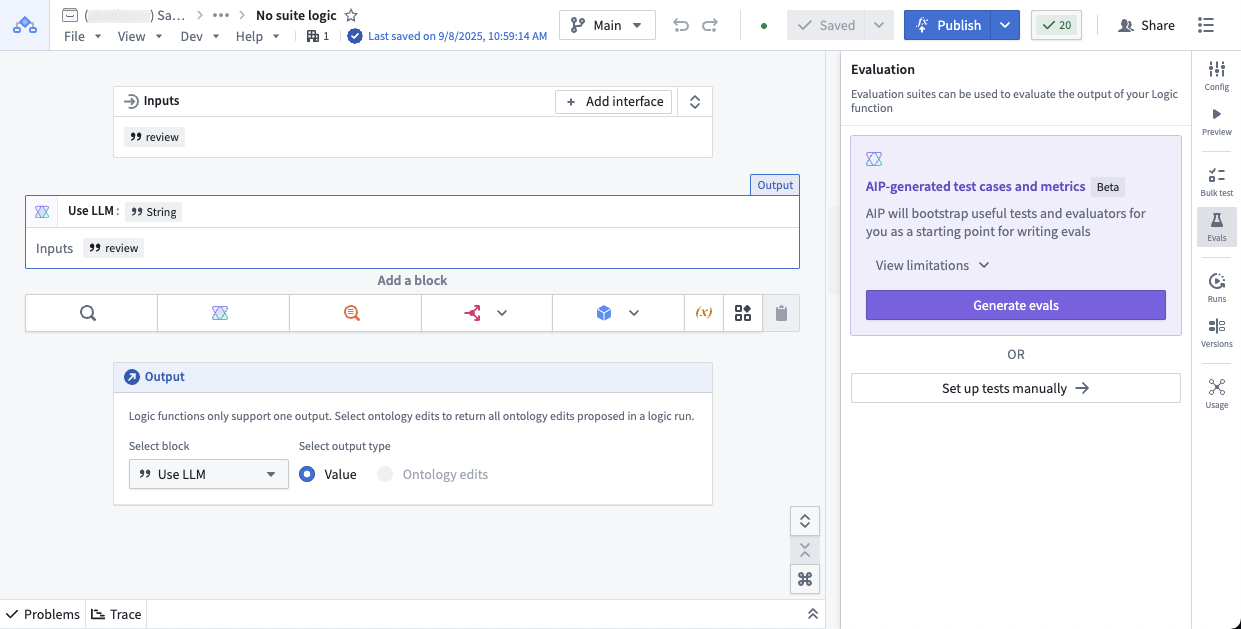
你可以为诸如 AIP Logic 函数、AIP Chatbot 函数以及代码编写的函数等目标函数创建评估套件:
AIP Logic 函数: 要开始在 AIP Logic 中使用评估套件,请参阅逻辑函数的评估套件。
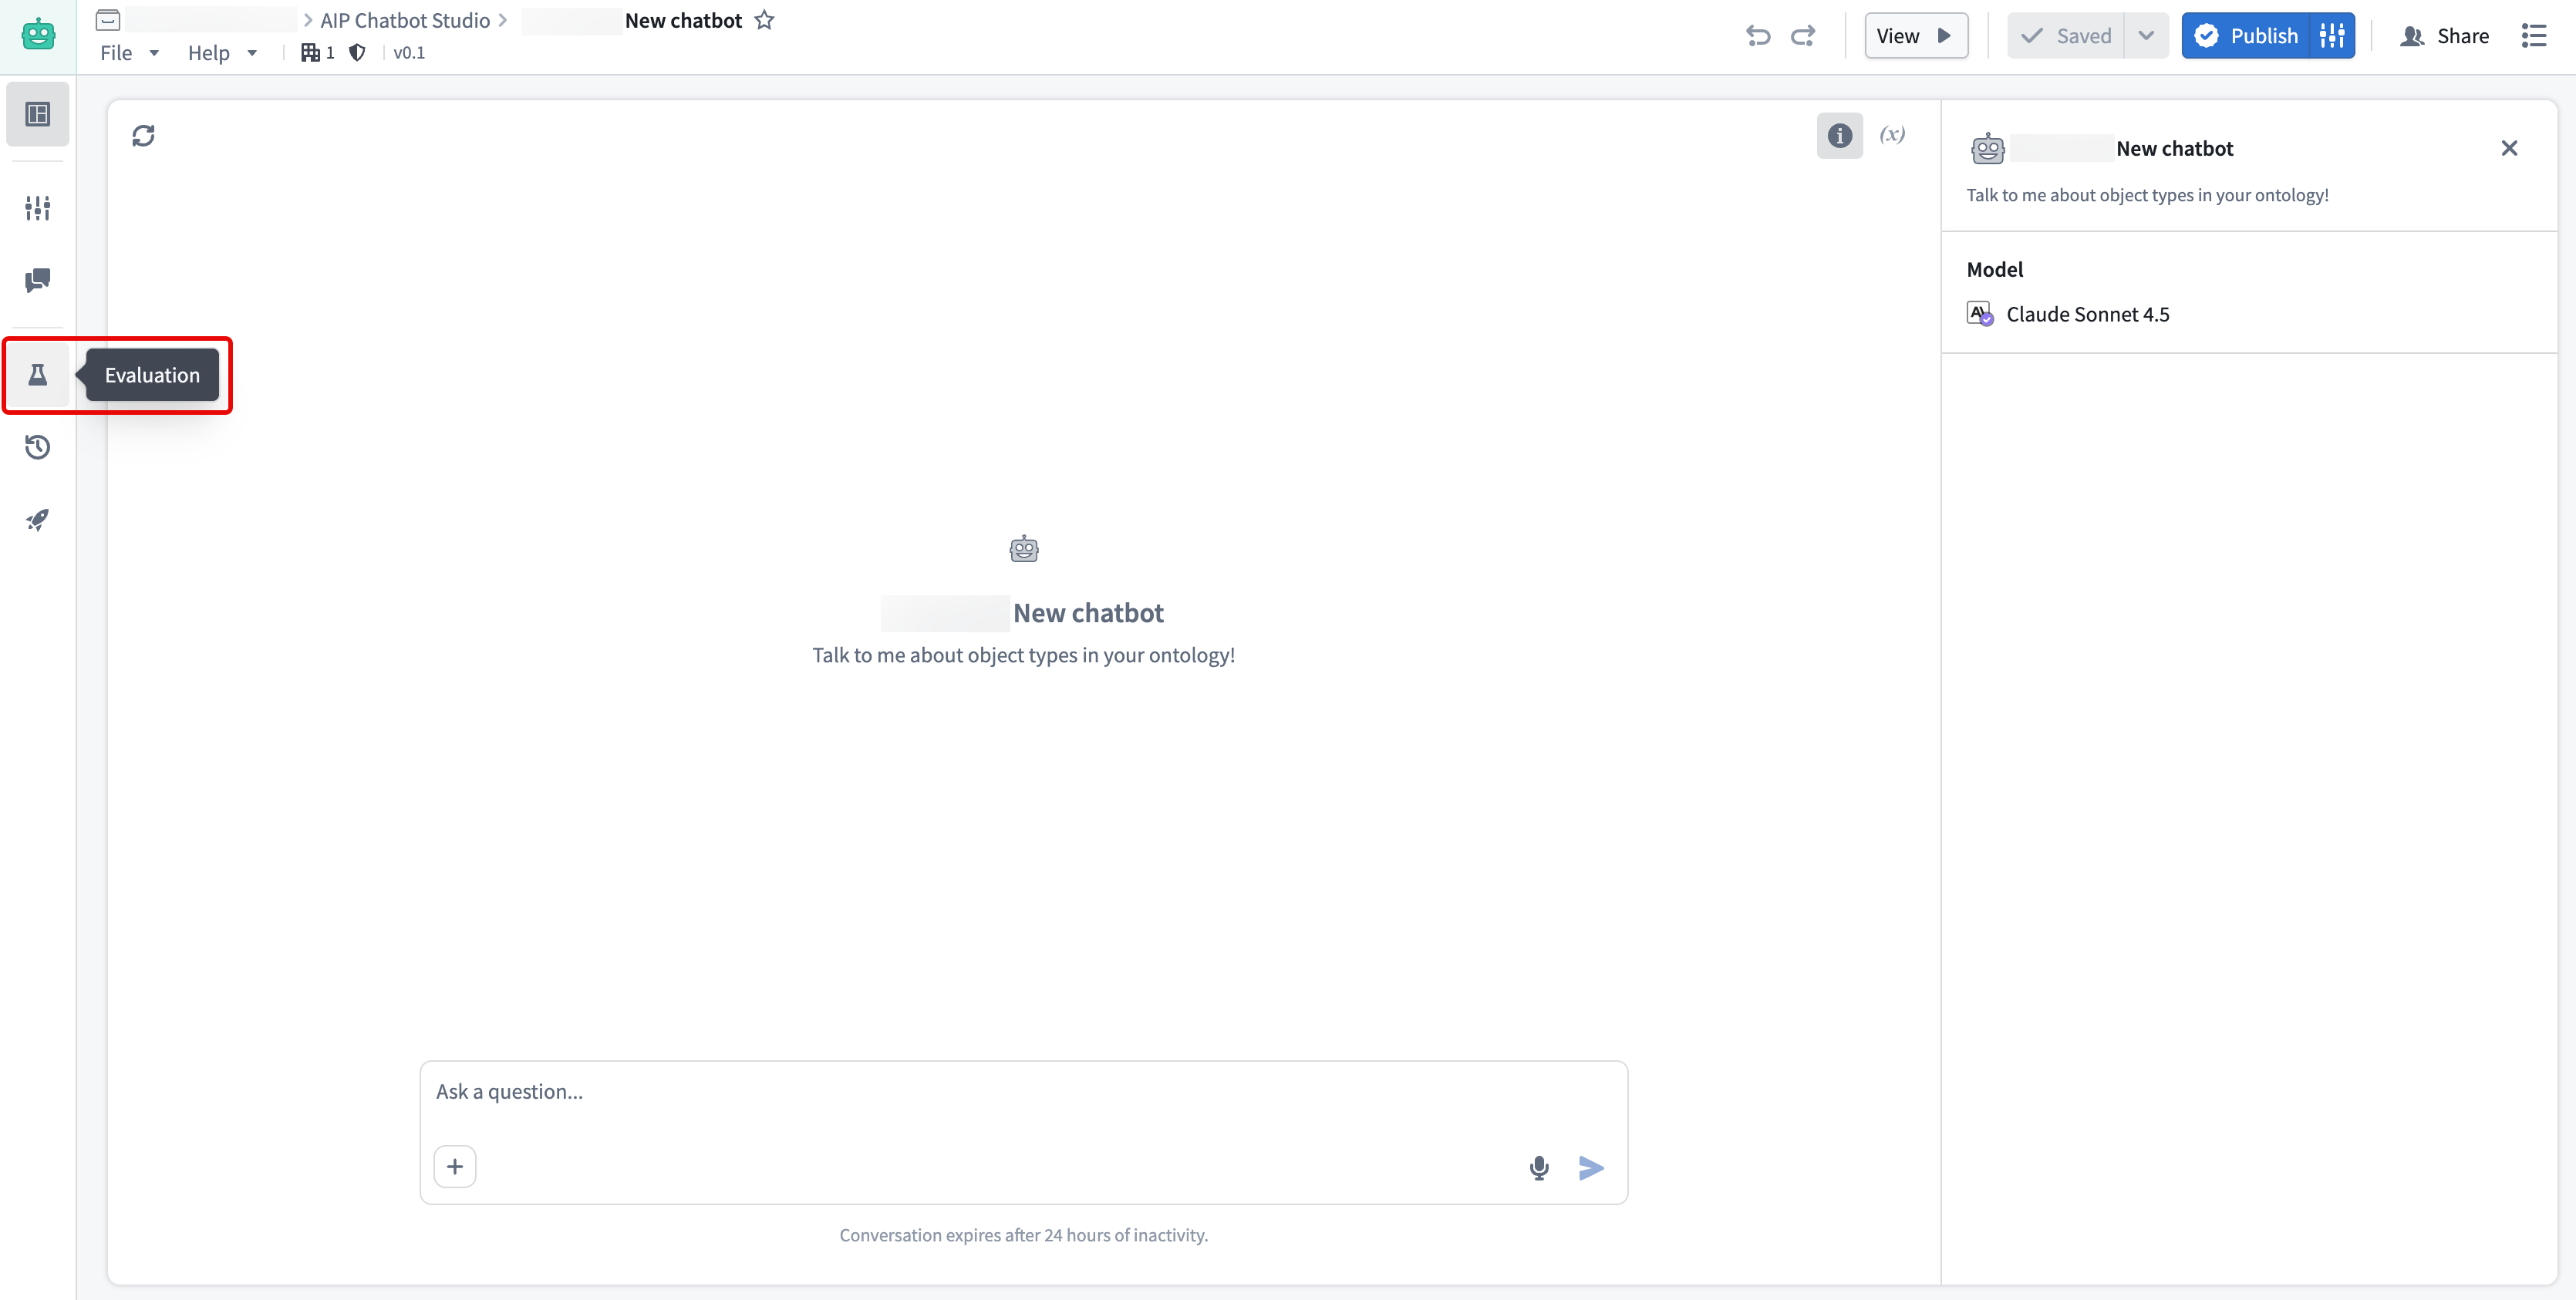
AIP Chatbot 函数: 要测试 AIP Chatbot 函数,你需要先将聊天机器人发布为函数。然后你可以在左侧边栏的 Evaluation 标签页中创建评估套件。由于侧边栏相似,你可以参考逻辑函数的评估套件一节了解更多信息。
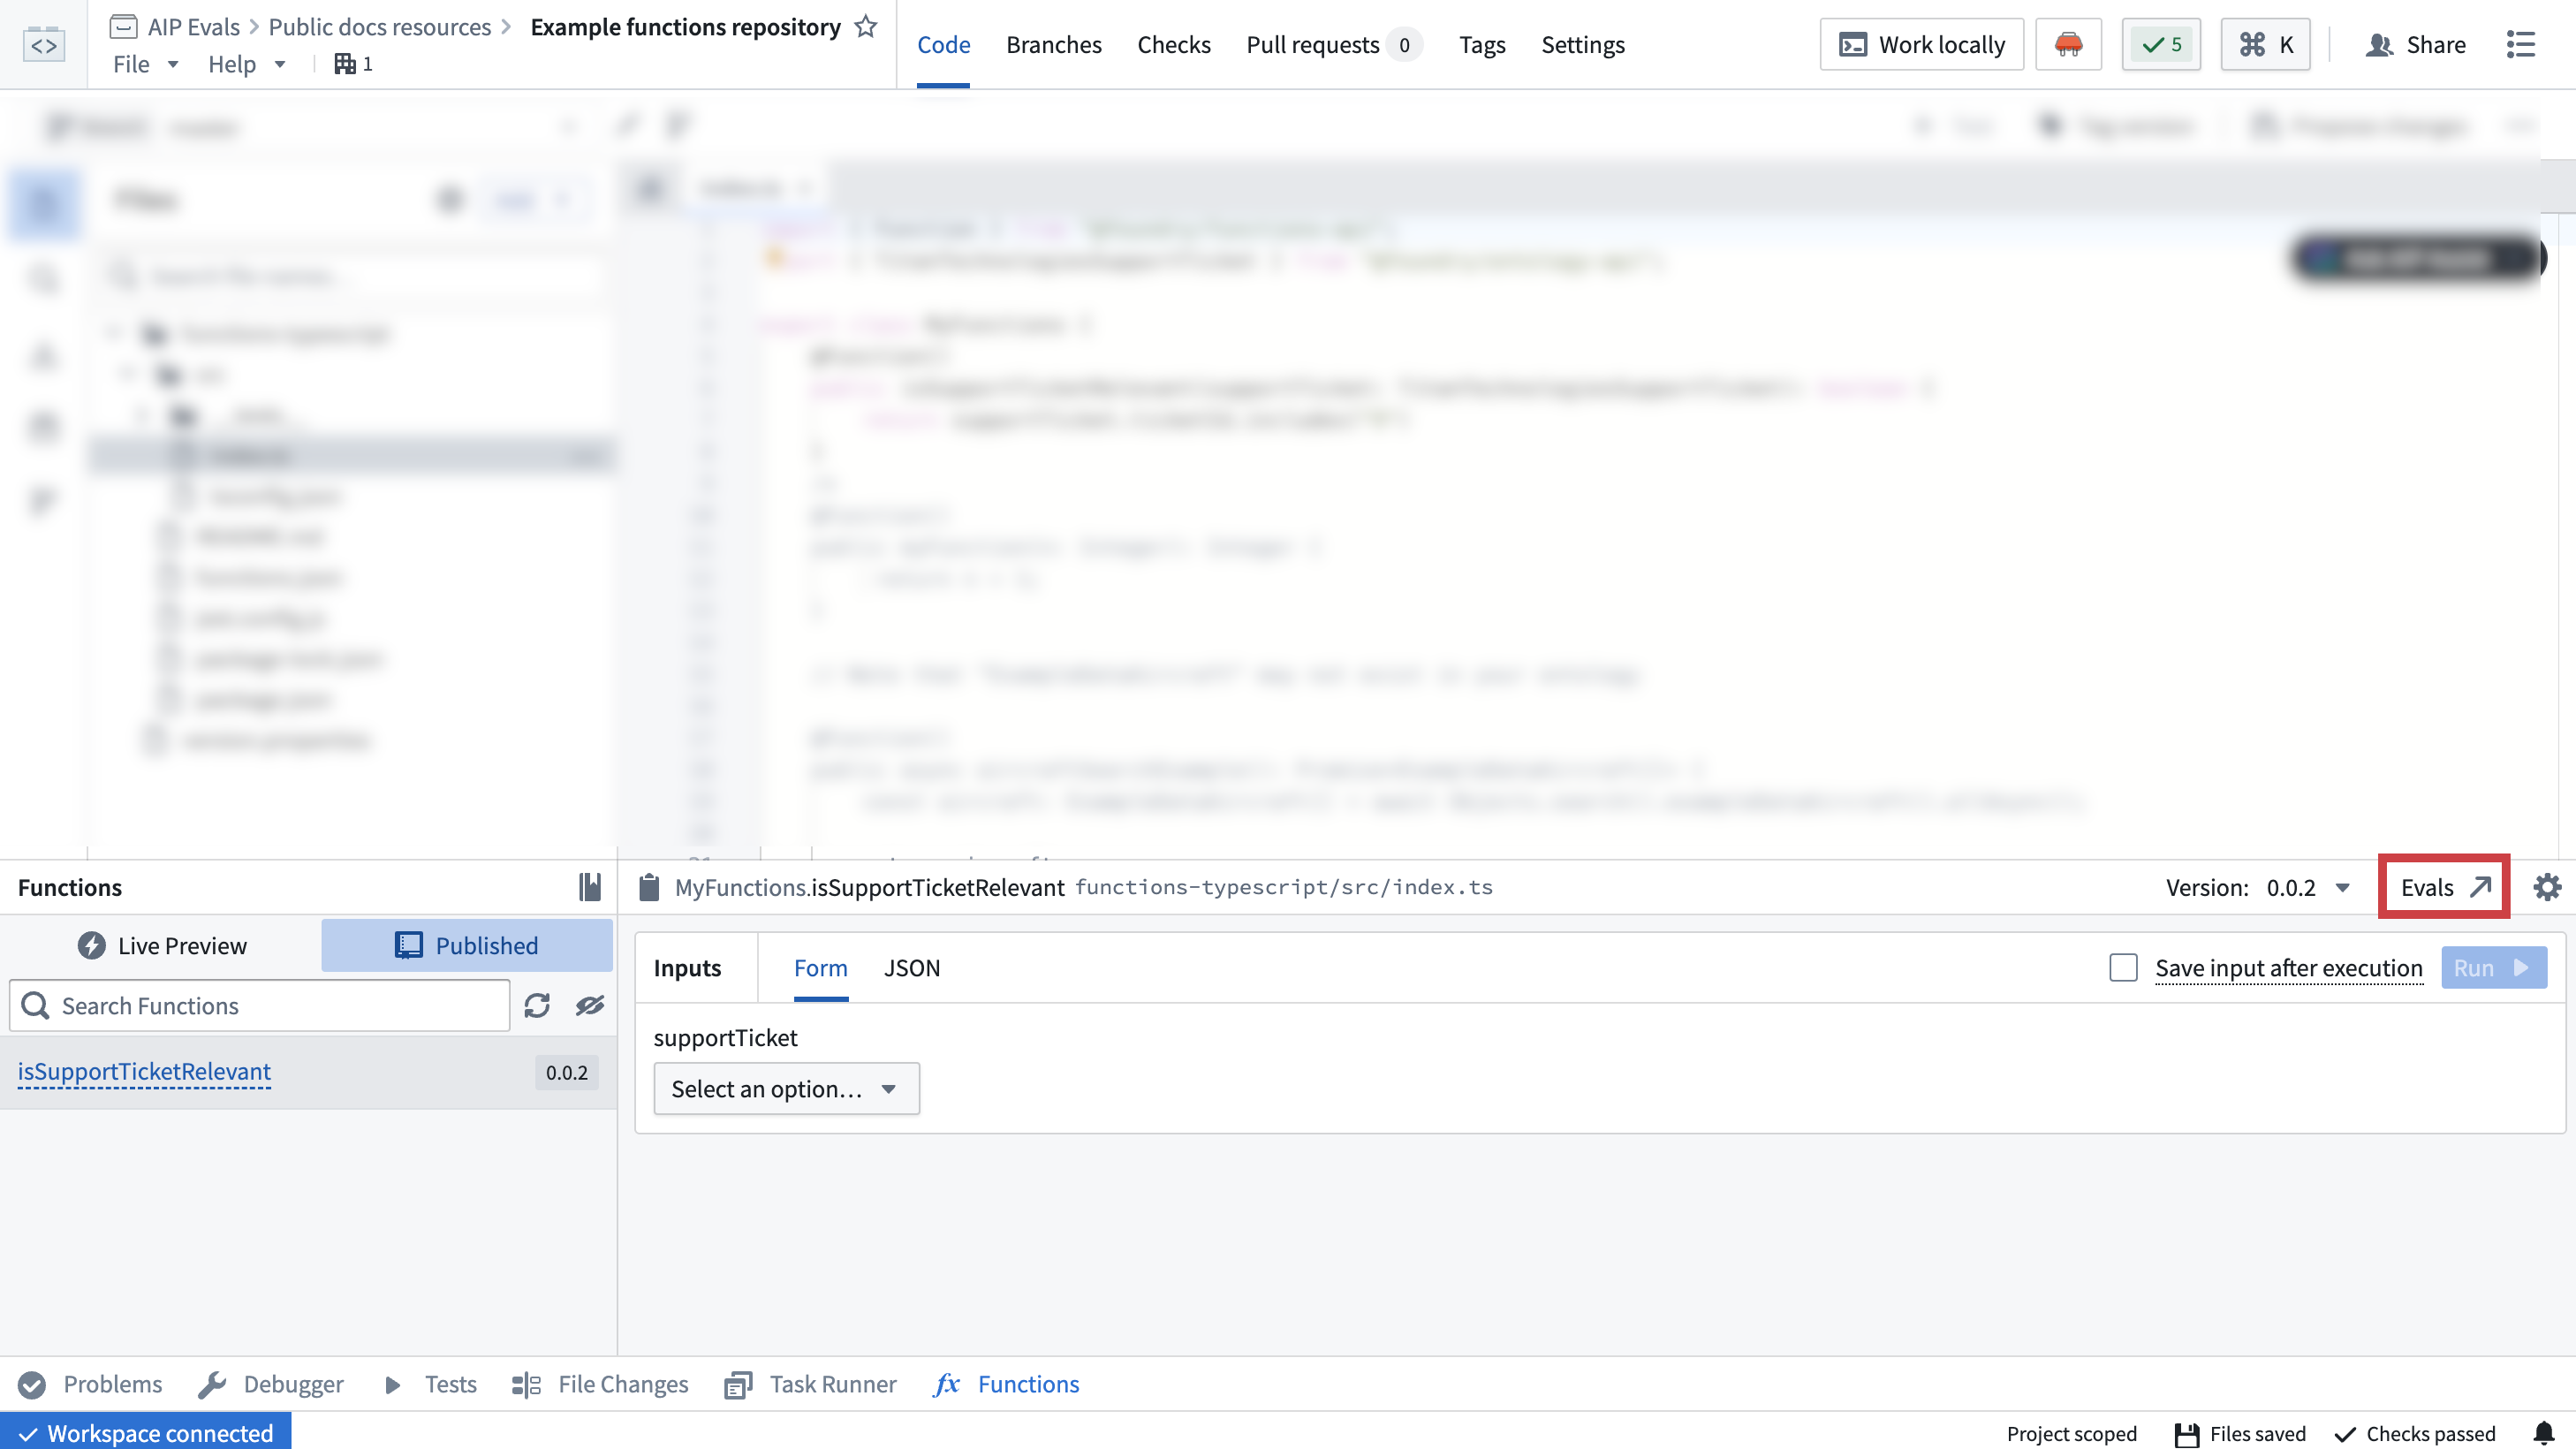
代码编写的函数: 你可以直接从 Published 标签页,通过导航到 Code Repositories > Code > Functions > Published,为在代码仓库(Code Repositories)中编写的函数创建并打开评估套件。
附加目标函数
你可以添加额外的目标函数,以使用同一个评估套件测试多个函数。这使你能够一次性针对不同的已发布 Foundry 函数或 Logic 函数运行评估。它对于比较不同实现之间的表现,或在同一批测试用例上评估相似函数非常有用。
要添加目标函数,请在 AIP Evals 中打开你的评估套件并选择 Add target function。每个目标函数可以有不同的输入/输出签名,且评估器按目标分别配置。
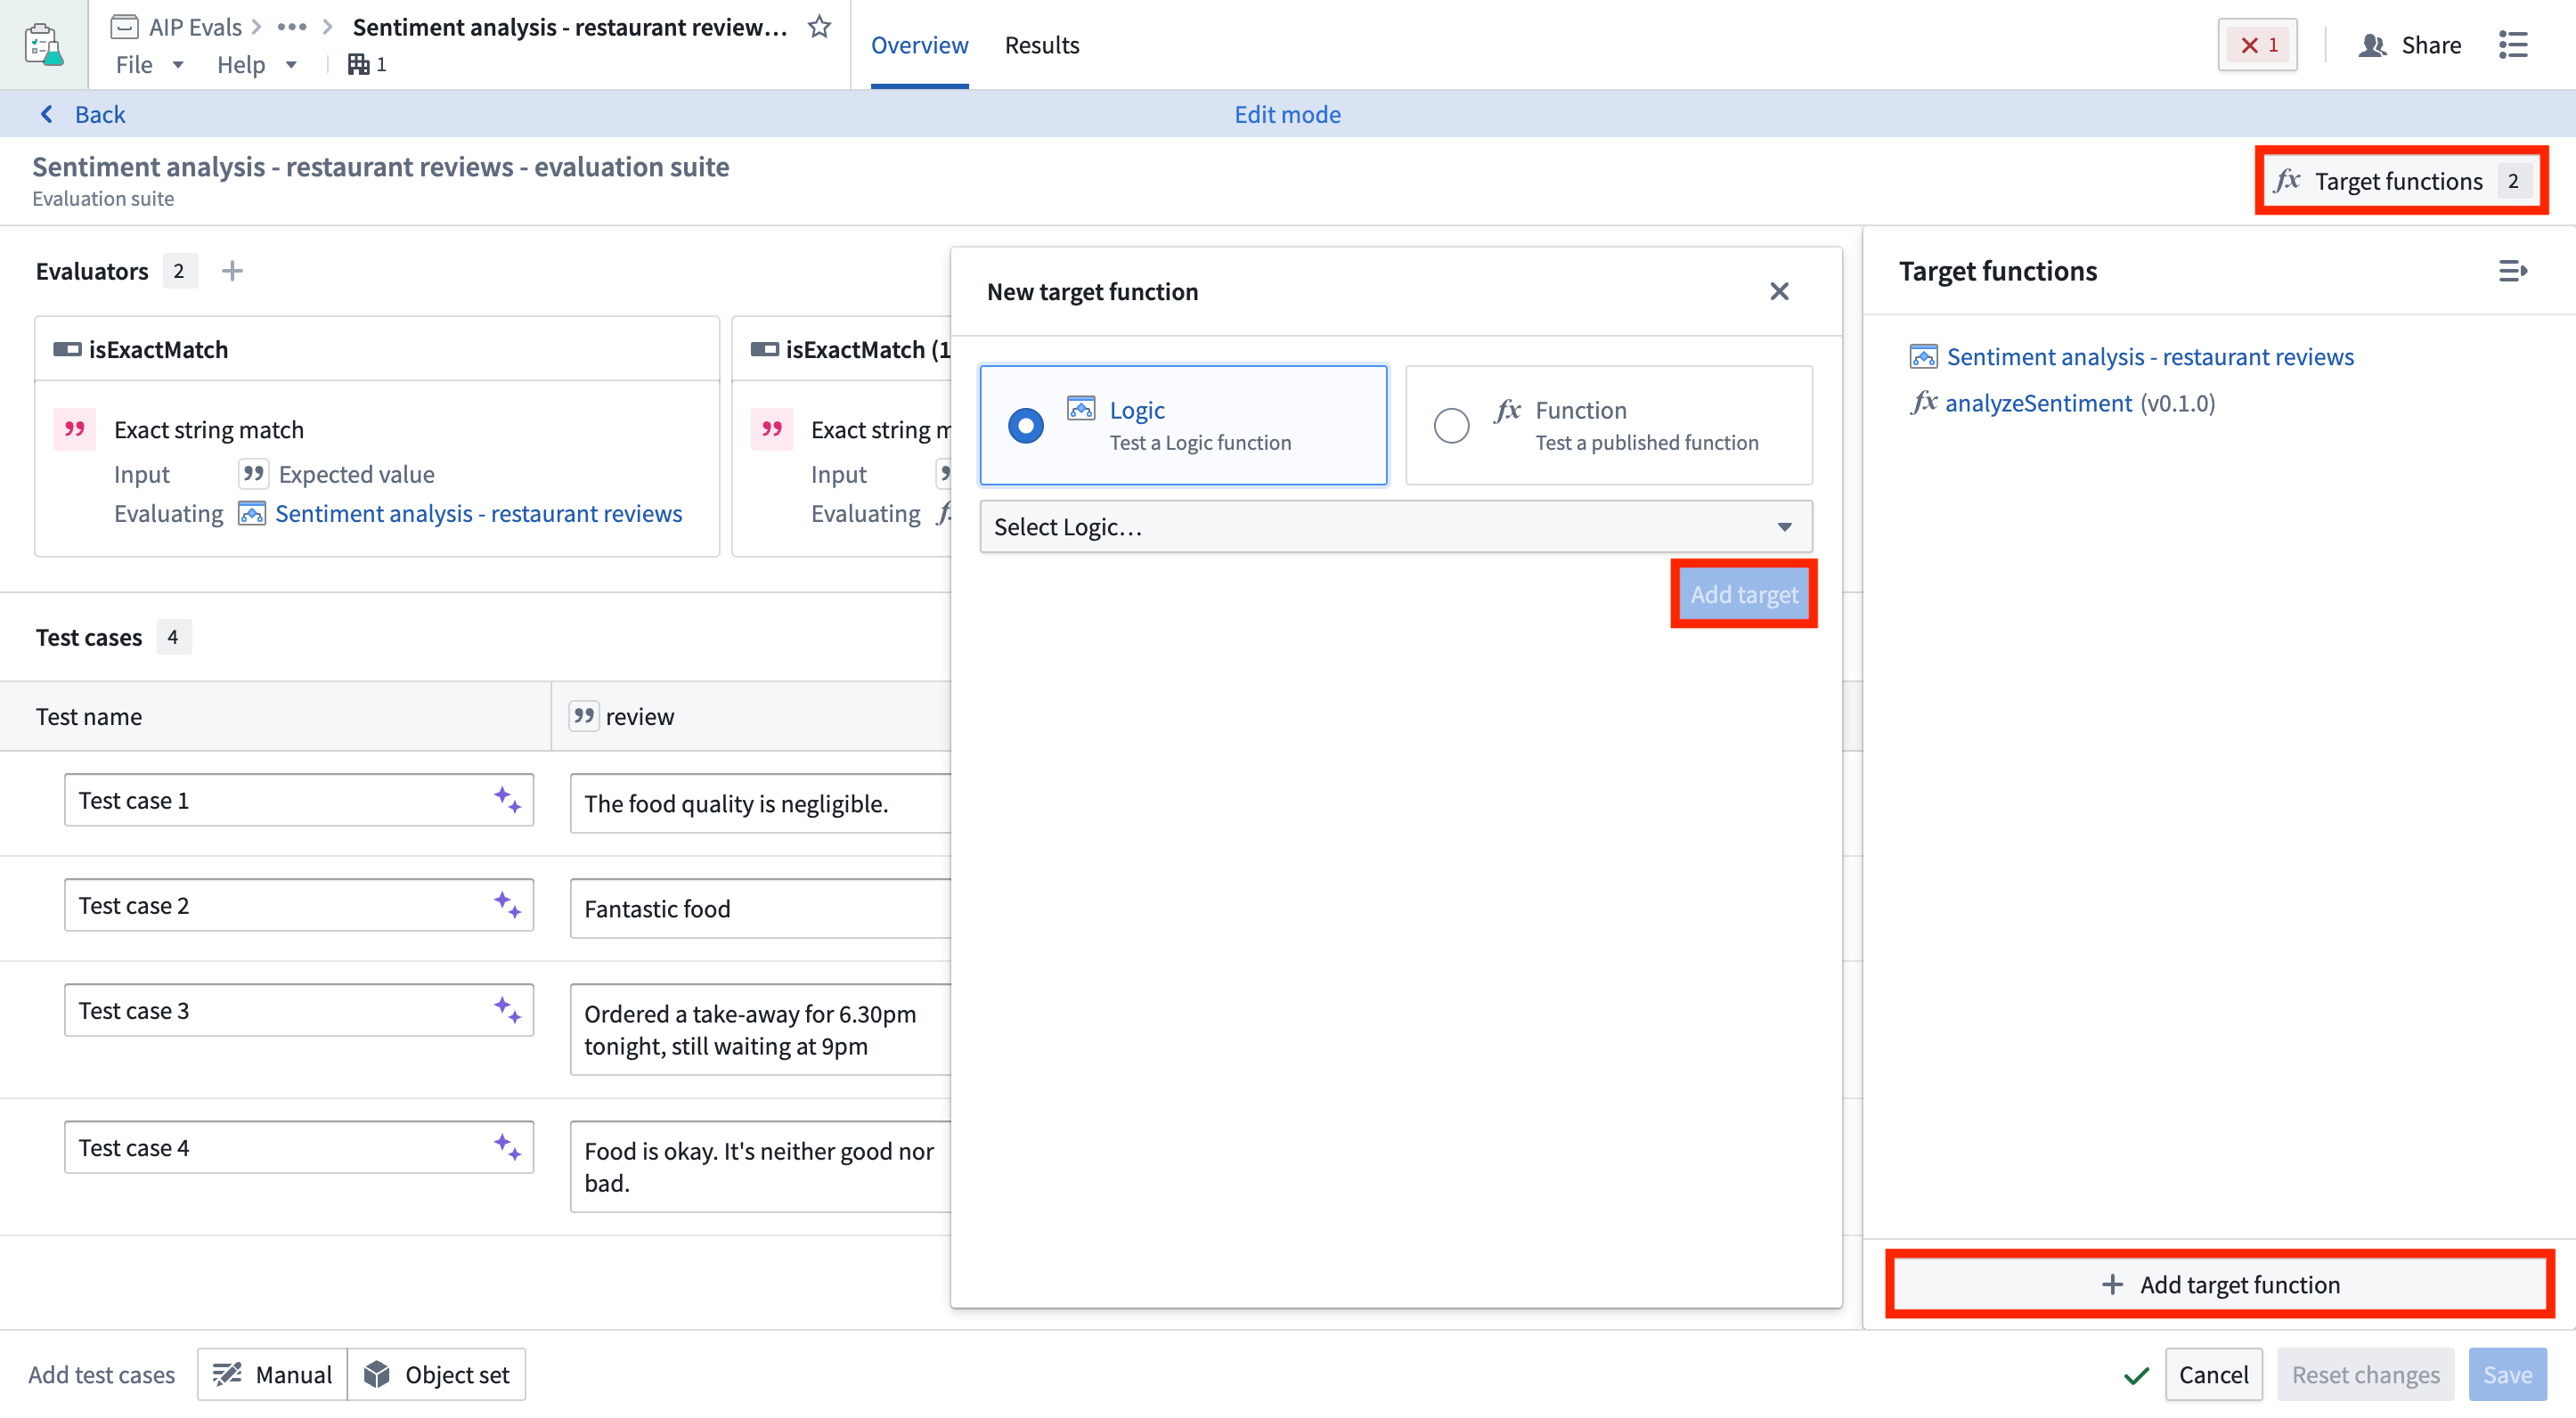
当你配置了多个目标后,你可以在运行评估套件时选择要包含哪些目标。
添加测试用例
你可以通过手动定义单个测试用例、使用对象集(object set)生成多个测试用例,或在同一个套件中结合两种方式,来为评估套件创建测试用例。这种灵活性使你能够利用现有的对象集,同时按需添加特定的手动测试用例。
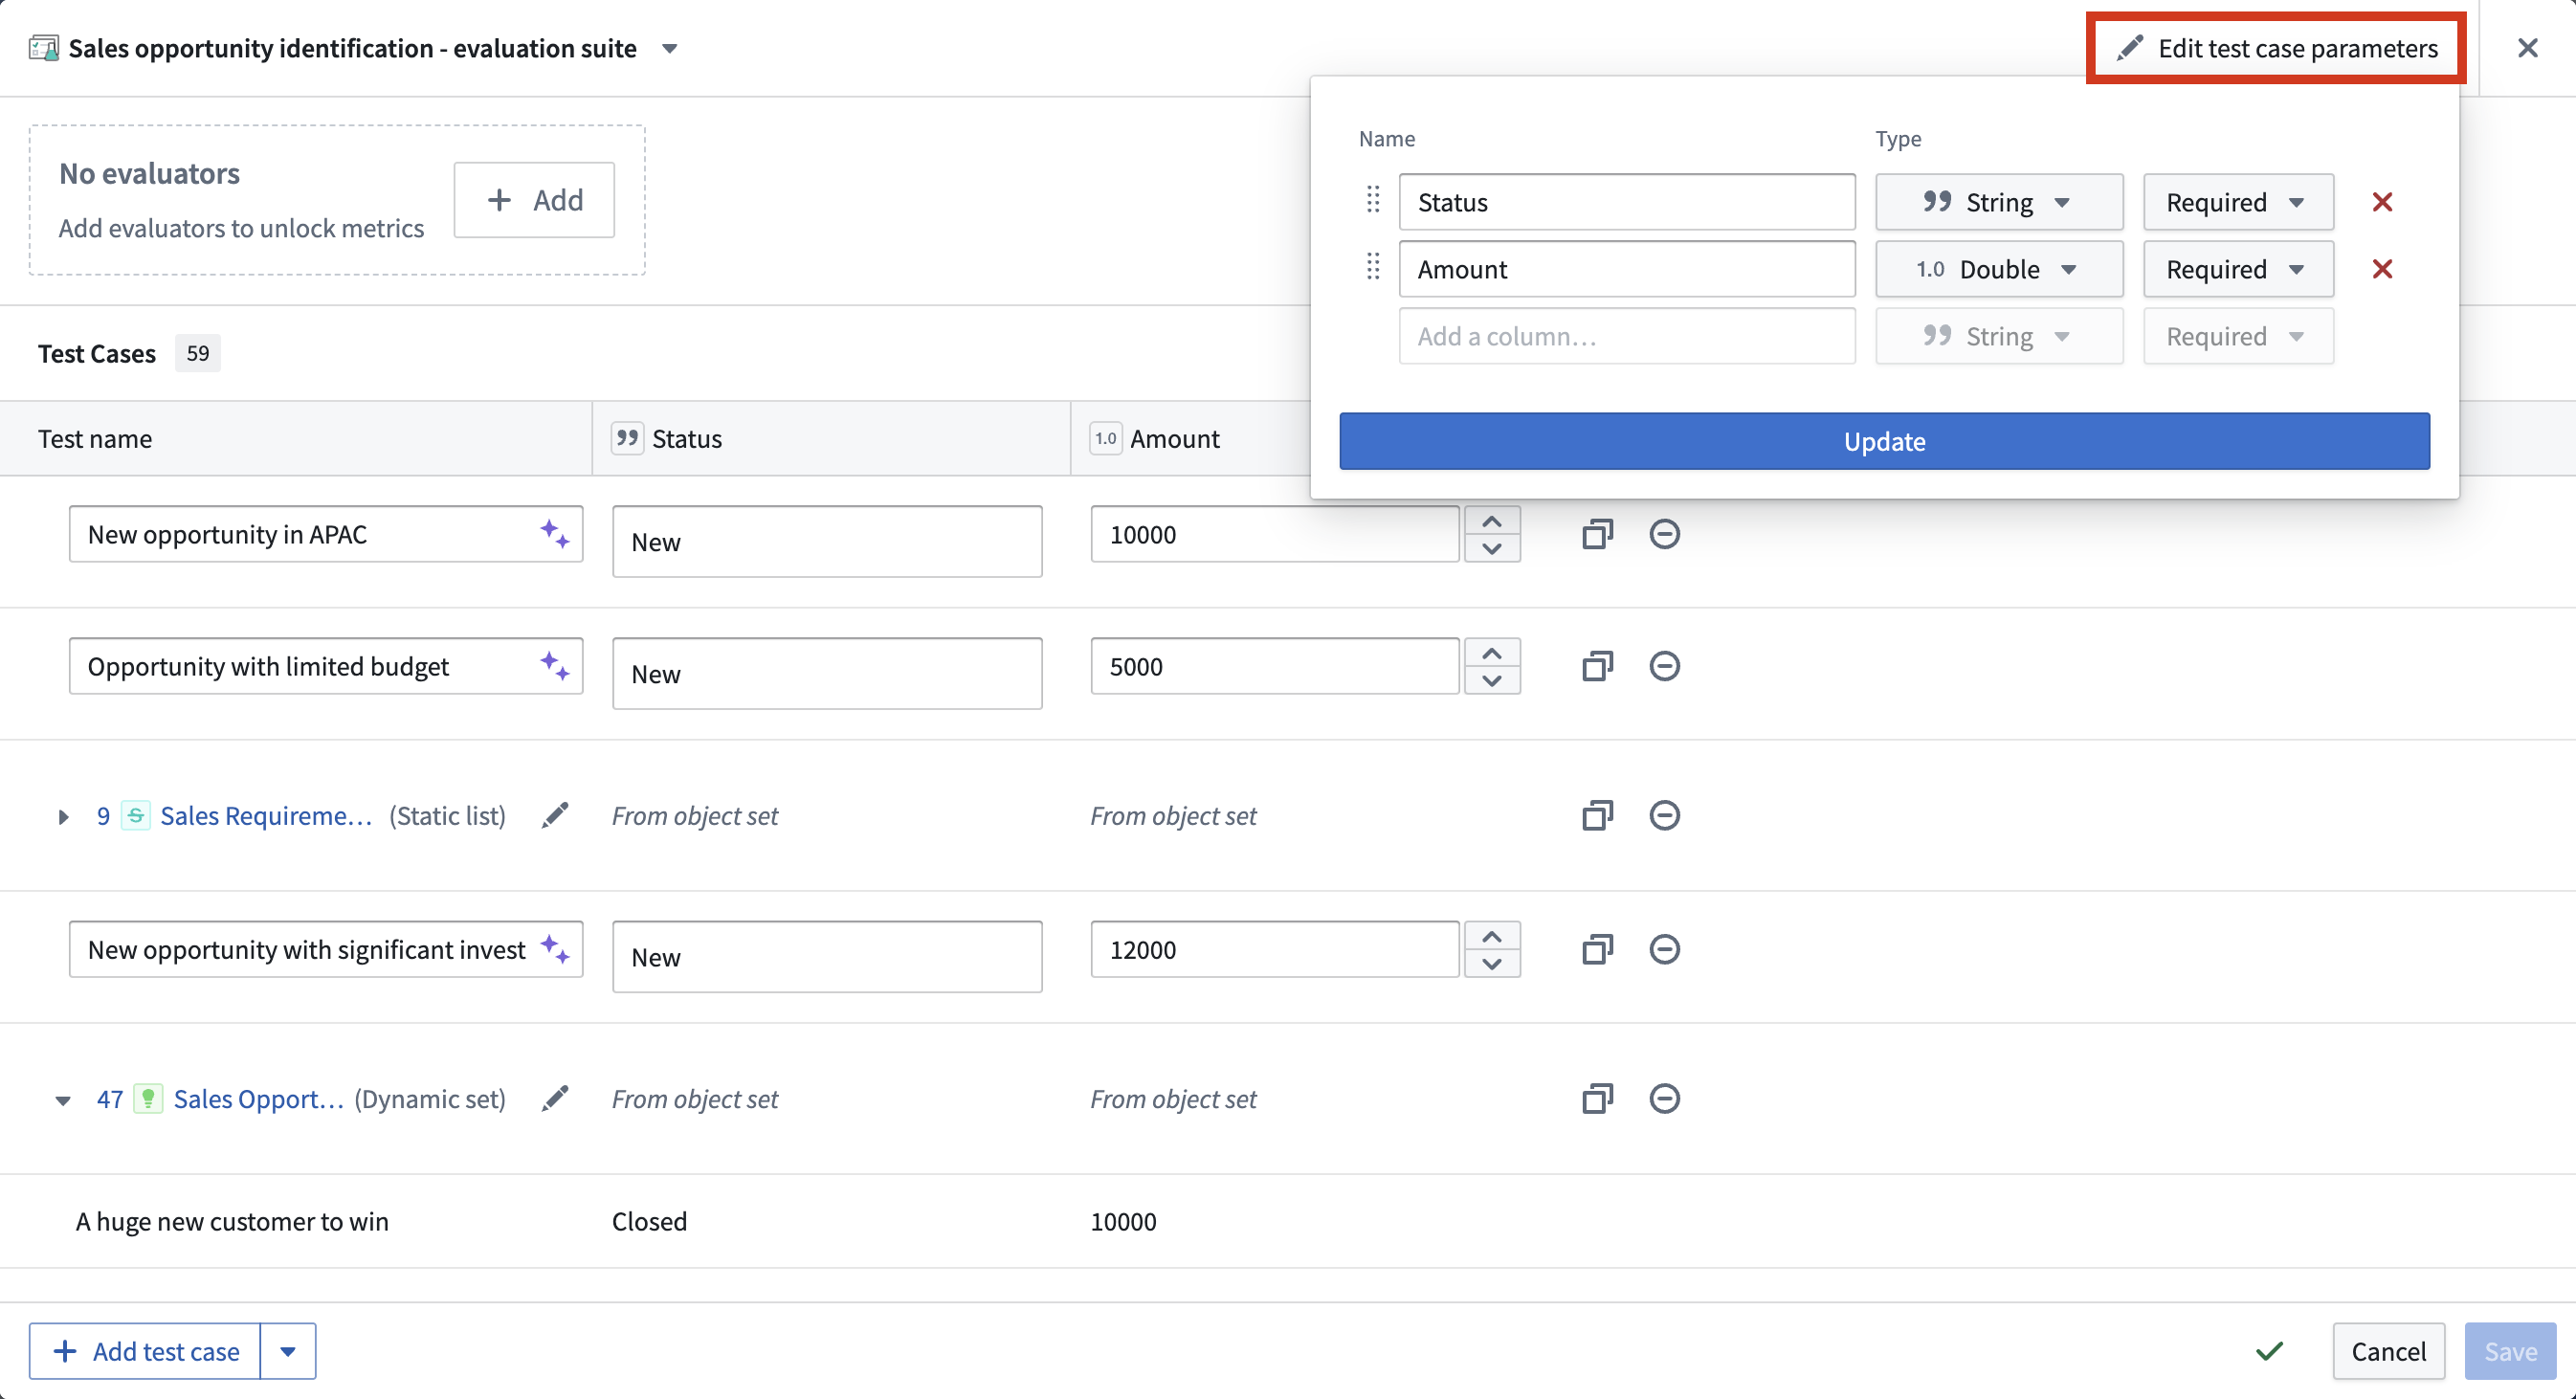
你可以通过选择 Edit test case parameters 来编辑评估套件列。然后,你可以添加、移除测试用例列及其各自的类型,或重新排序。
Manual test cases
要手动定义测试用例,请在评估套件视图的左下角选择 Add test case。为每个测试用例命名,然后在相应的列中定义输入及其期望值。你可以选择测试用例名称旁的紫色 AIP 星形图标来生成建议名称。
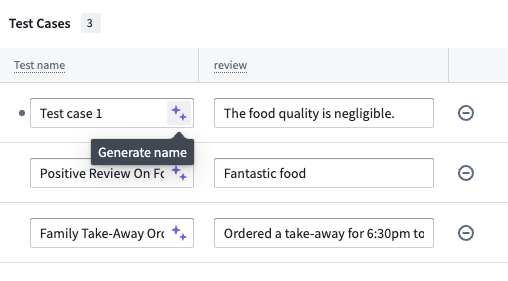
在本示例中,建议名称 Negative Review On Food Quality 比 Test case 1 提供了更多信息:
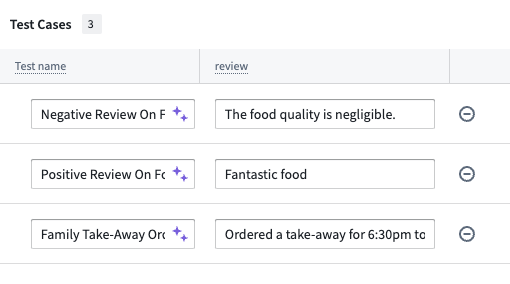
手动测试用例非常适合测试特定的边缘情况、在你的对象集中可能代表性不足的场景,或者当你希望对测试输入和期望输出进行精确控制时。
Object set test cases
你也可以从对象集添加测试用例,此时每个测试用例将由所选对象集中的一个对象表示。要添加对象集测试用例,请选择 Add object set,并在对象集选择对话框中选择你要使用的对象集和对象属性。
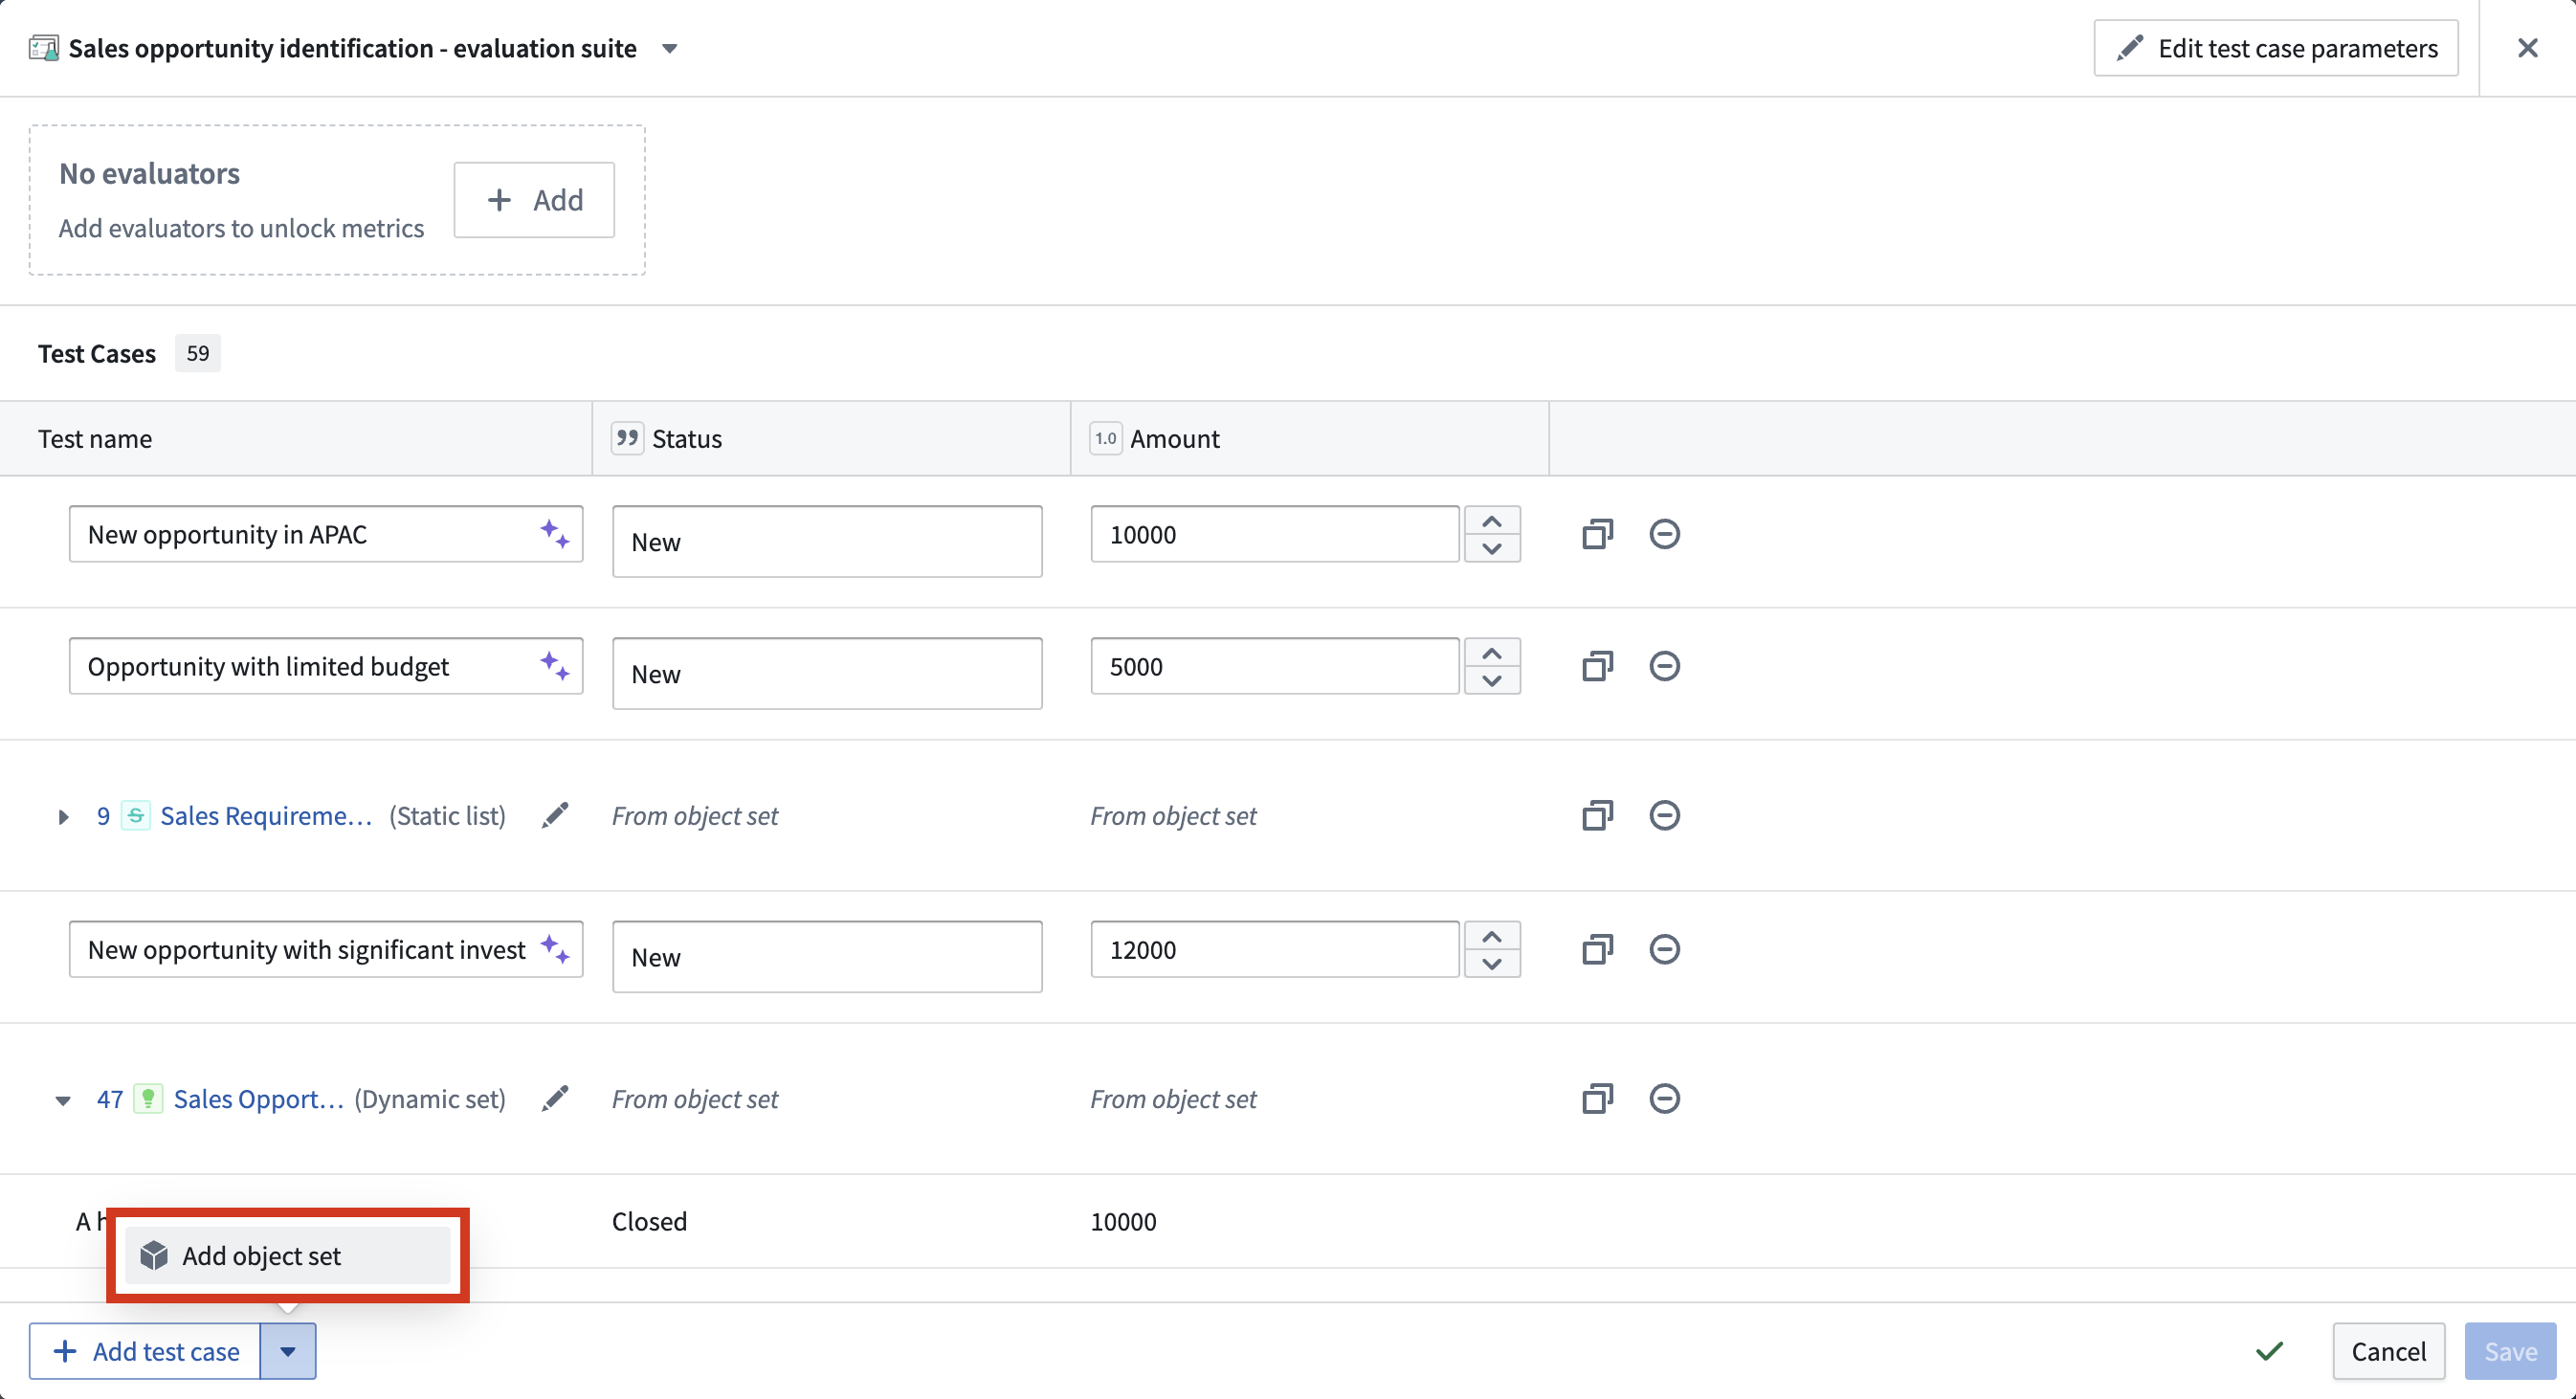
对象集测试用例对于使用真实数据进行大规模测试特别有用,可确保你的函数在你实际数据的代表性样本上正常工作。你可以向同一个评估套件添加多个对象集,并将它们与手动测试用例结合,以创建全面的测试覆盖。
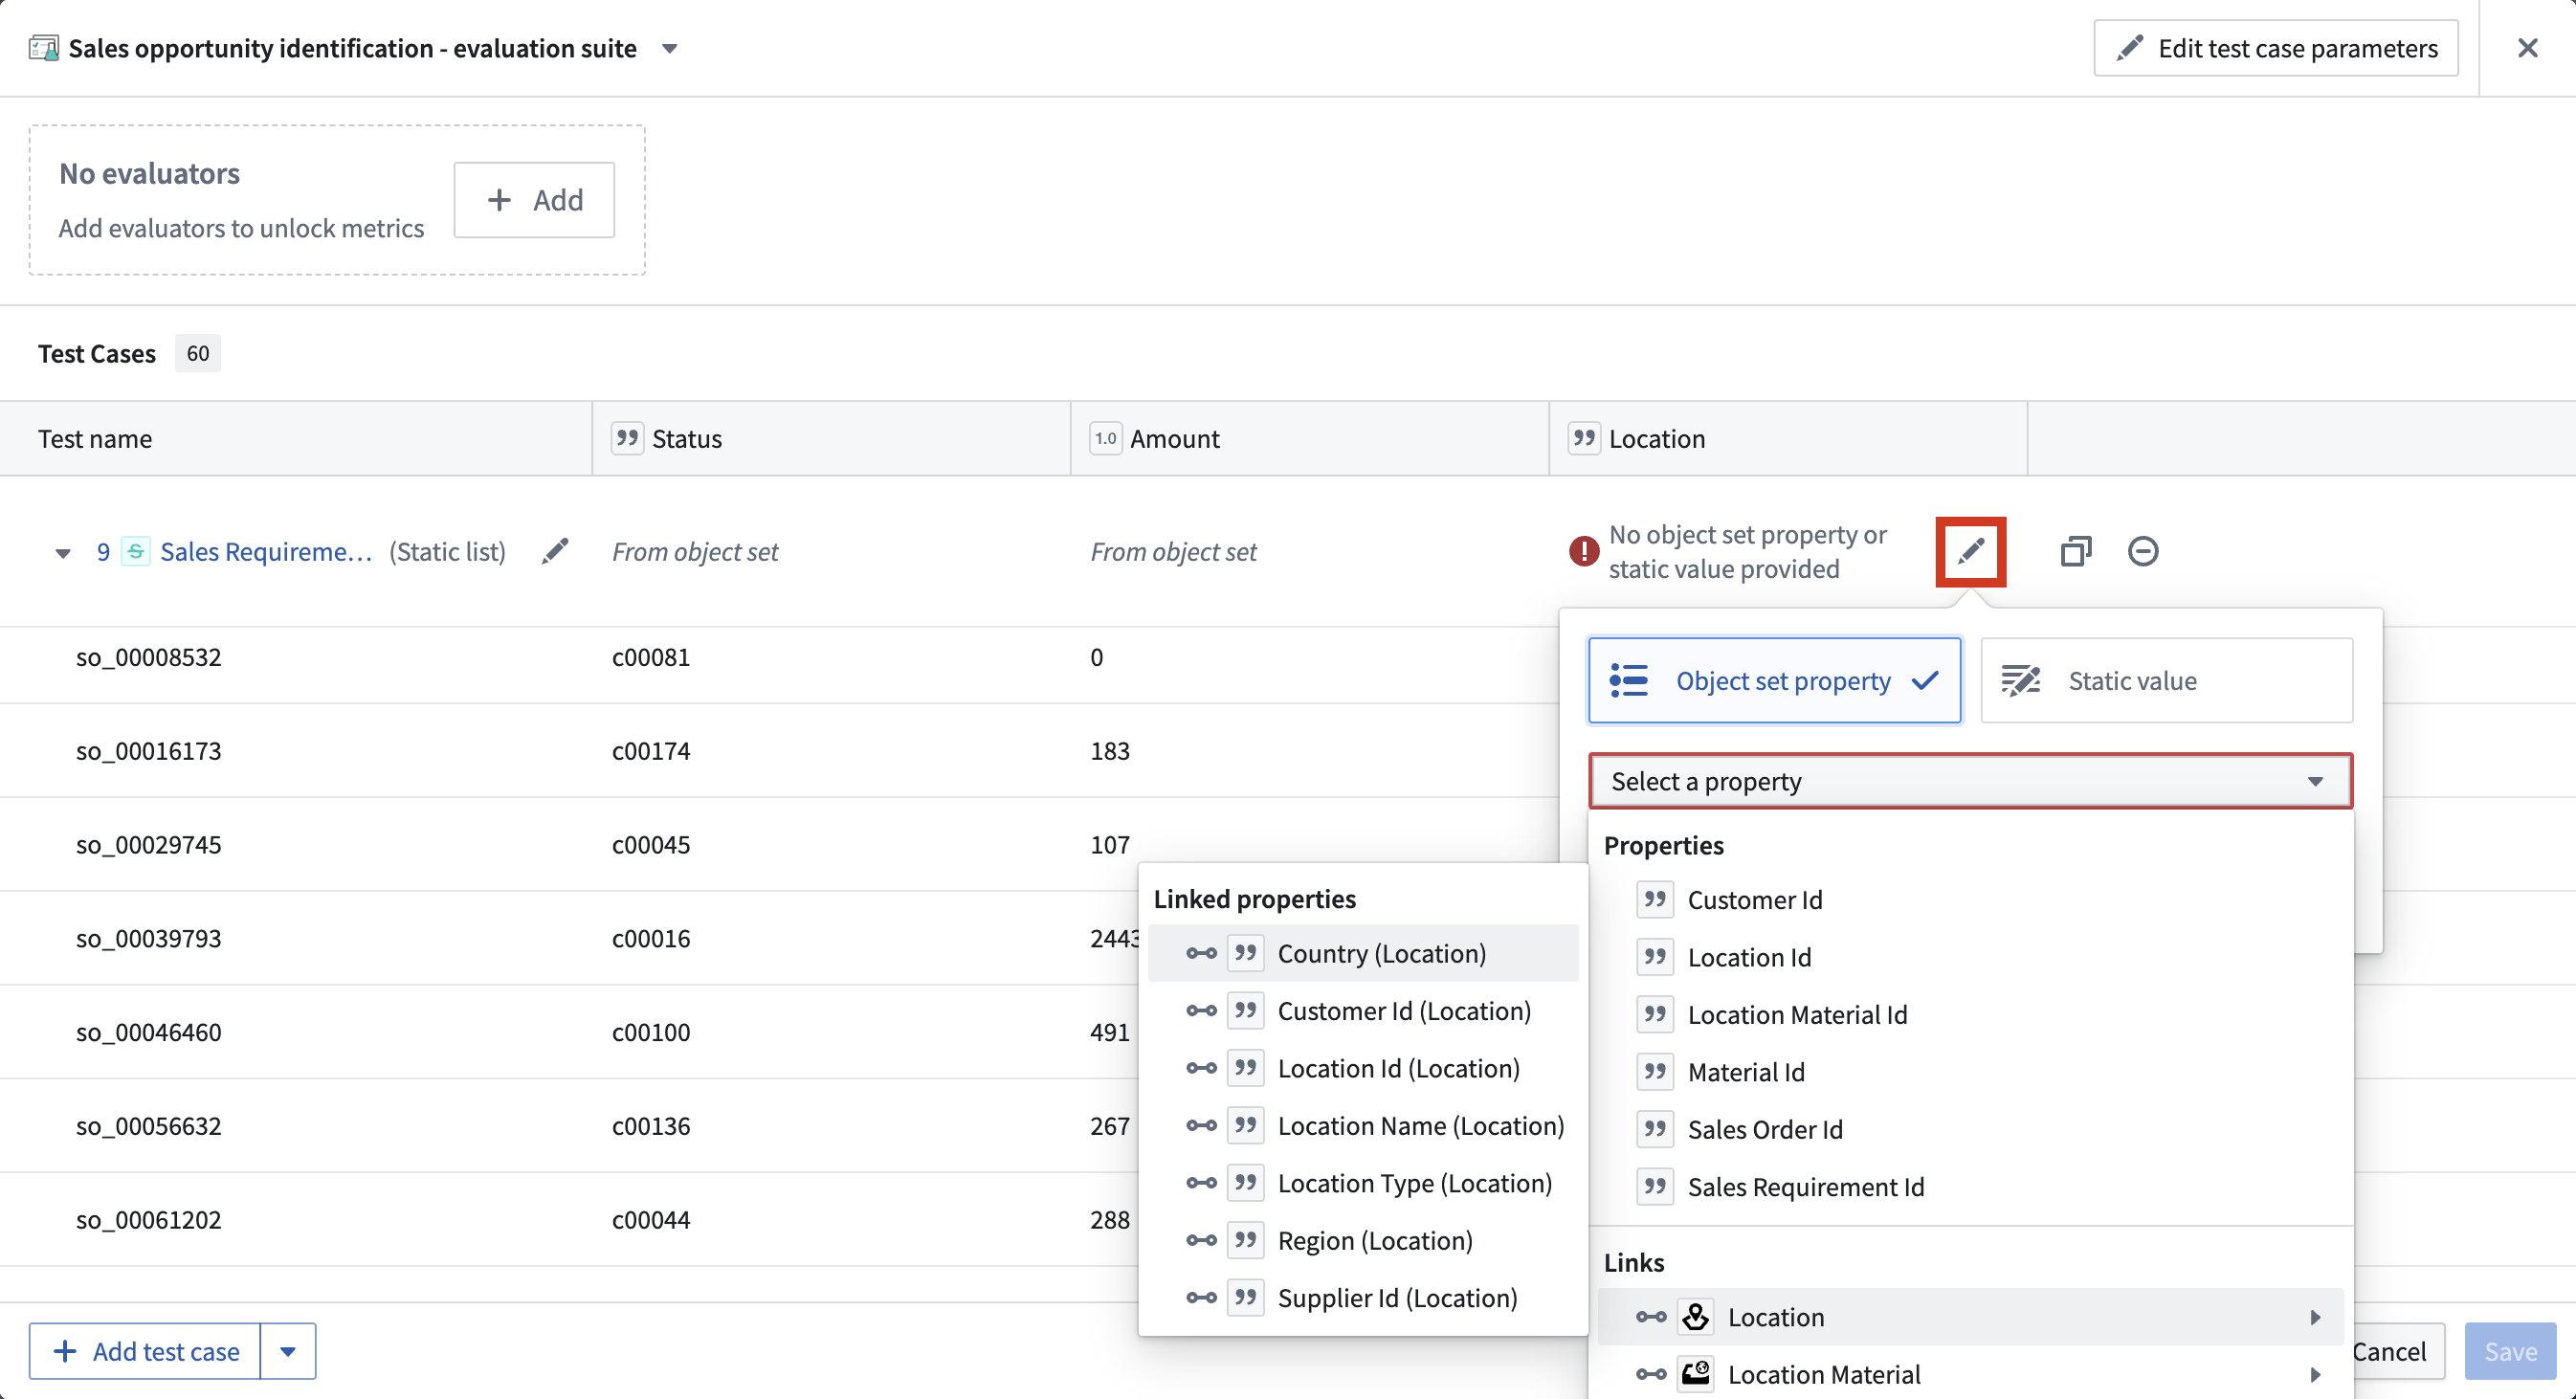
支持对象集可以通过在配置对话框中选择 Edit object set configuration 图标来编辑。属性也可以使用对象集标题列单独编辑。
对象集可以配置为向评估套件列提供不同类型的数据。这些包括:
- 支持对象集的对象
- 支持对象集的对象属性
- 链接到支持对象集的对象或对象集
- 链接对象或链接对象集的属性(仅在 Object Storage v2 中可用)
- 应用于支持对象集每一行的静态值
评估器
评估器是一种用于将受测函数的输出与期望输出进行评估的方法。评估器可以返回简单的 true/false 结果,但也可以产生诸如语义距离之类的数值。没有评估器的评估套件可用于在多种场景中执行函数并手动审查每个输出。然而,评估器使得大规模衡量并客观化运行结果成为可能,因为它们会产生可比较的表现指标。
AIP Evals 提供了一些内置评估器,将在下一节中描述。你也可以定义自定义评估函数,以基于特定标准衡量表现。
Add an evaluator
要添加评估器,请在测试用例表格顶部选择 + Add。这将打开一个选择面板,你可以在其中从内置评估器或自定义评估器列表中进行选择。
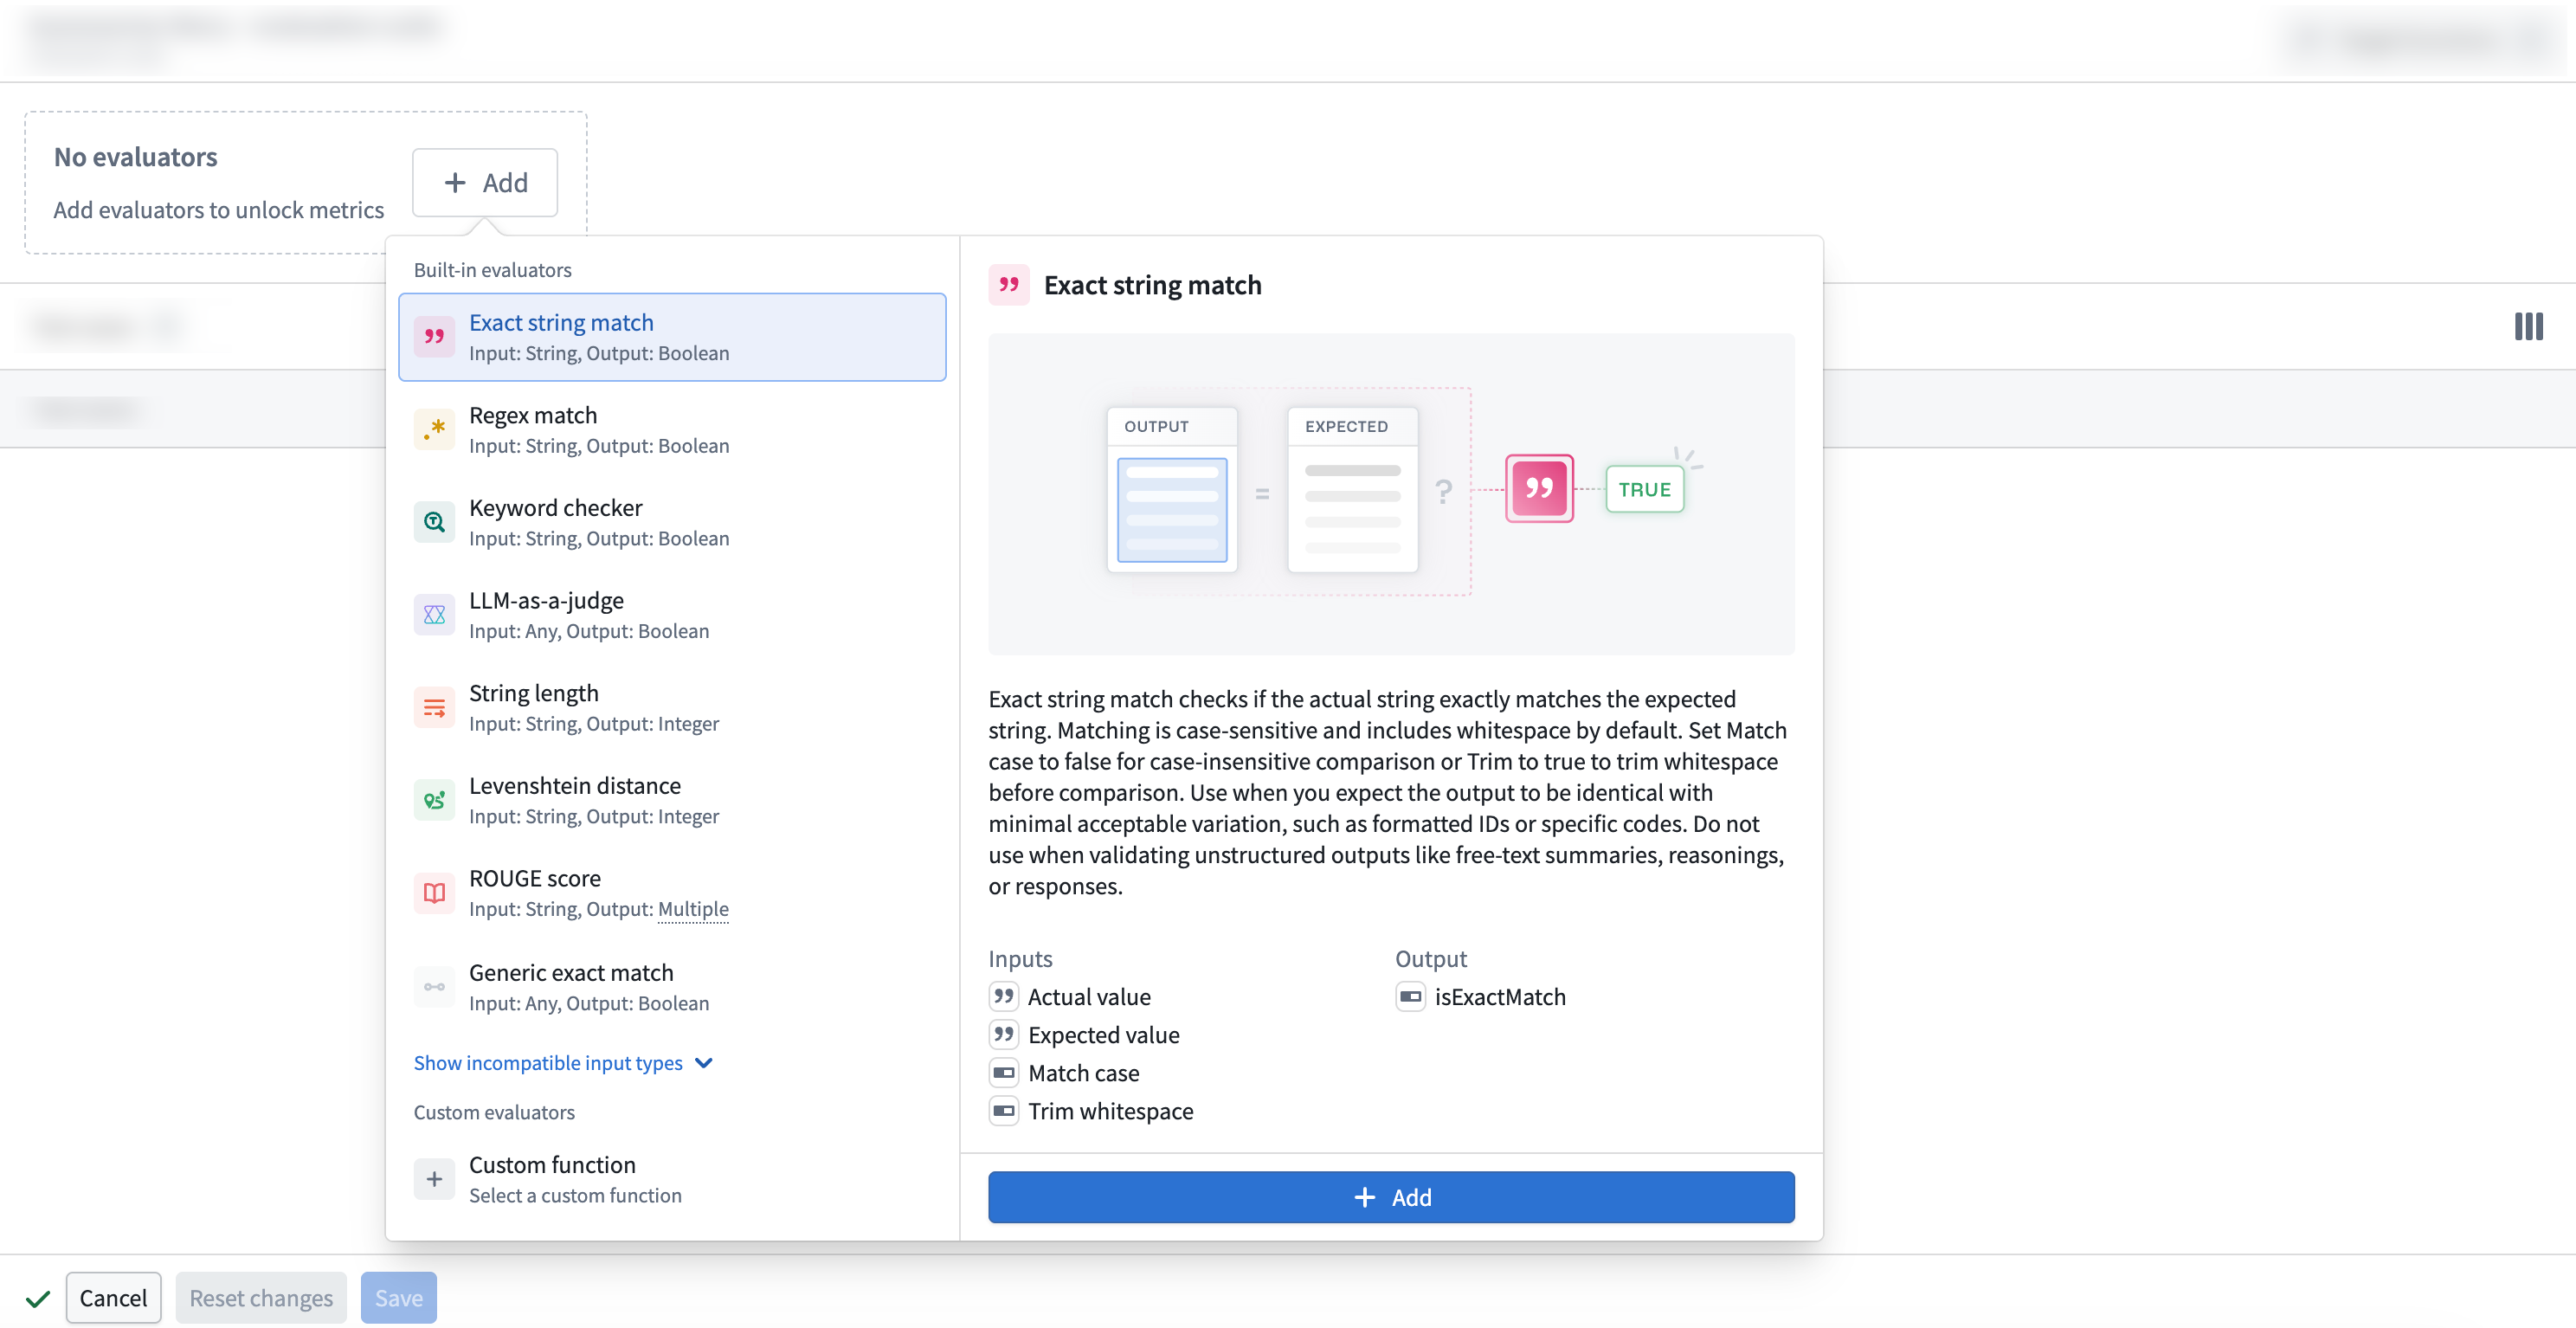
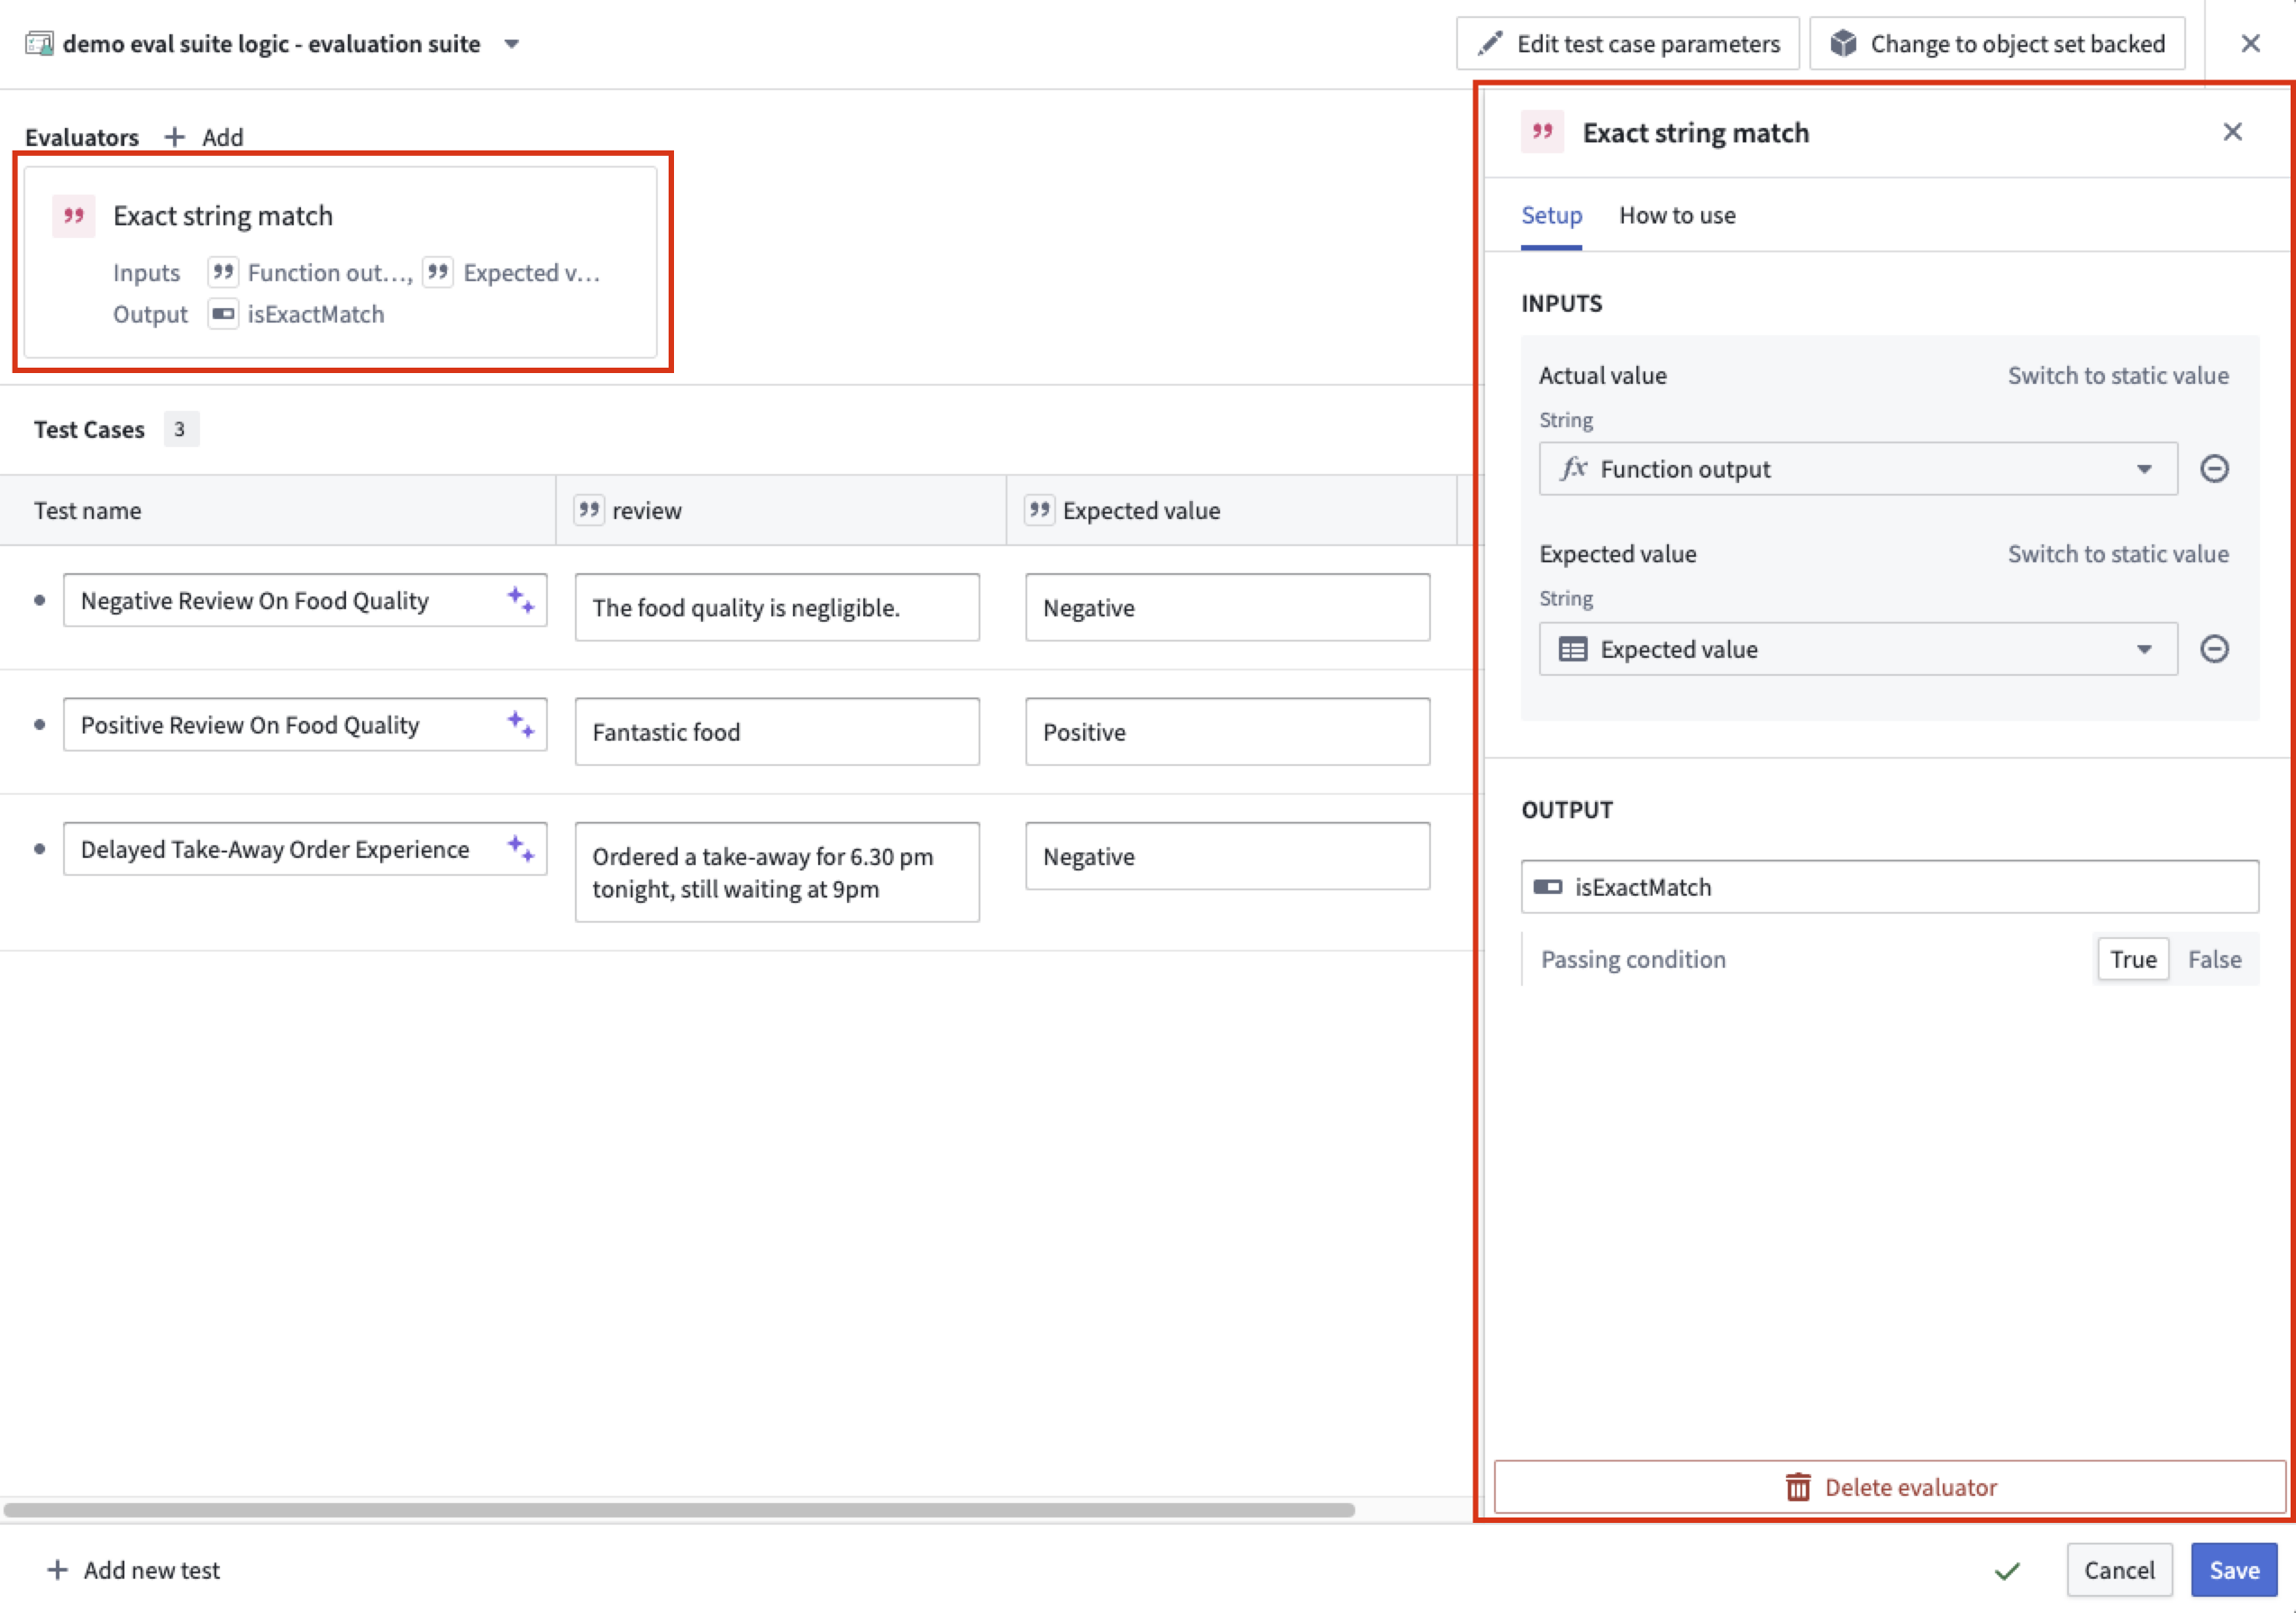
一旦你选择了评估器并选择 + Add,该评估器将被添加到你的测试用例表格中。然后,你可以通过将函数输出映射到测试用例表格中的 Actual value 列、将期望值映射到 Expected value 列,来配置该评估器。
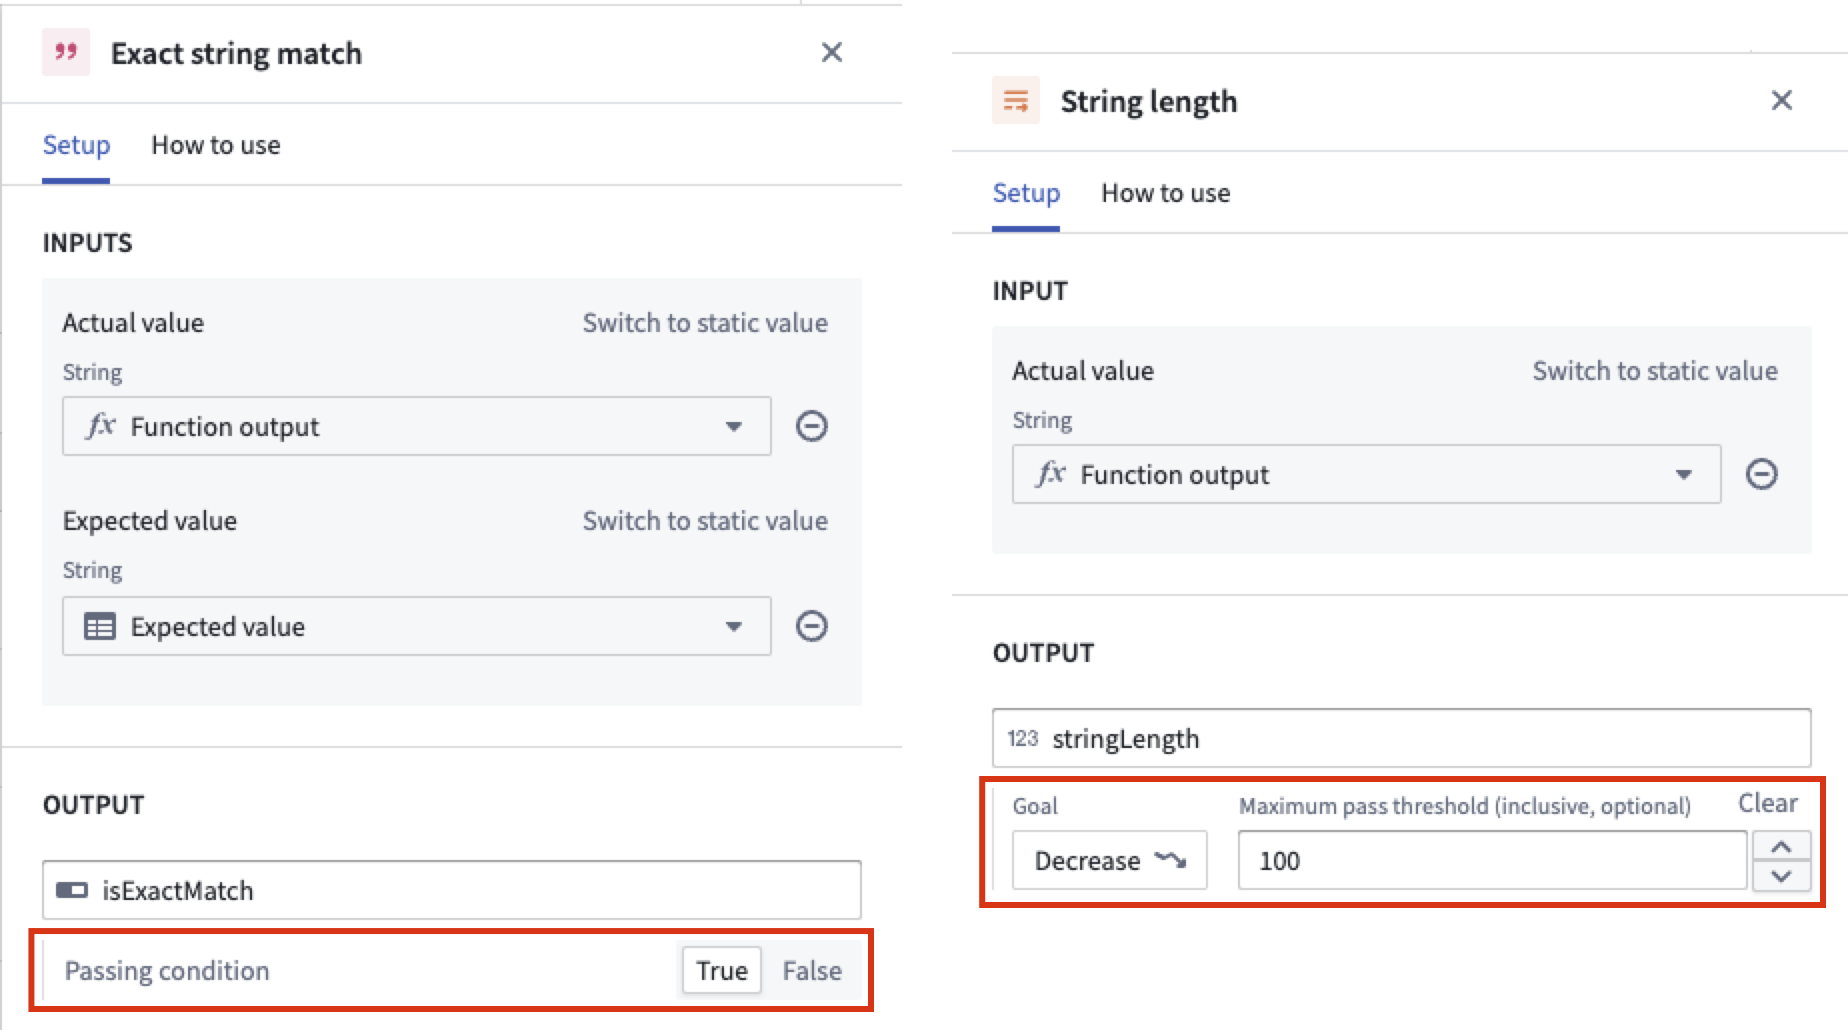
配置评估器时,你可以为每个指标定义一个目标。对于布尔型指标,指定指标应为 true 还是 false。对于数值型指标,设置优化方向;指定为最大化(值越高越好)或最小化(值越低越好)目标。你还可以定义一个阈值:
- 对于最大化目标,设置最小阈值(例如,"score must be at least 10")。
- 对于最小化目标,设置最大阈值(例如,"score must be at most 0.05")。
如果某个测试用例迭代中的指标满足所配置的目标,则该指标被视为通过。对于布尔型指标,这取决于指标是 true 还是 false。对于数值型指标,这取决于指标是否高于或低于阈值(若已定义)。如果所有指标都满足所配置的目标,则整个测试用例迭代被视为通过。具有多次迭代的测试用例,如果所有迭代都通过,则被视为通过。
Built-in evaluators
内置评估函数的示例包括:
- Exact boolean match: 检查实际布尔值是否与期望布尔值完全相等。
- Exact Boolean array match: 检查两个布尔数组是否包含相同的元素。默认情况下比较与顺序有关,但这可以配置。
- Exact string match: 检查实际字符串是否与期望字符串完全匹配。默认情况下匹配区分大小写且包含空白字符,但这可以配置。
- Exact string array match: 检查两个字符串数组是否包含相同的元素。默认情况下比较与顺序有关、区分大小写且包含空白字符,但这可以配置。
- Regex match: 检查实际字符串是否与期望的正则表达式匹配。
- Levenshtein distance: 一种用于衡量两个序列之间差异的字符串度量。计算将一个词转换为另一个词所需的最小单字符编辑次数(插入、删除或替换)。
- String length: 检查实际字符串的长度是否落在期望范围内。
- Keyword checker: 检查实际文本中是否存在特定关键词。
- Exact object match: 检查实际对象是否与期望对象完全相等。
- Object set contains: 检查实际对象是否与目标对象集中的某个对象完全相等。
- Object set size range: 检查所提供对象集的大小是否落在期望范围内。
- Integer range: 检查实际值是否落在期望值的范围内。仅支持整数。
- Exact numeric match: 检查两个数字是否完全相等。支持 integer、long、float、double 和 short 类型。
- Exact numeric array match: 检查两个数值数组是否包含相同的元素。支持 integer、long、float、double 和 short 类型。默认情况下比较与顺序有关,但这可以配置。
- Floating-point range: 检查实际值是否落在期望值的范围内。所有数值类型均可作为参数。
- Temporal range: 检查实际值是否落在期望值的范围内。仅支持
Date和Timestamp值。 - Generic exact match: 检查实际值是否与期望值相同。数值类型在比较时会被强制转换(例如,整数可以与相同数值的 double 匹配),日期和时间戳类型也是如此。对象和对象集按引用比较,struct 和 map 按无序键值对比较,list 按有序元素比较,模型按标识符和参数比较。如果你的数据类型存在特定类型的评估器,则应使用它,因为它们提供细粒度的比较选项和更好的类型安全性。
- LLM-as-a-judge: 使用 LLM 来评估用户定义的条件对给定值是否成立。当条件满足时返回
true,否则返回false。接受任何类型(引用类型除外:对象定位符、对象 RID、对象集或模型)作为实际值。需要以清晰、可验证的断言形式编写的条件参数,以及一个可用于评估的模型。 - ROUGE score: 衡量实际(生成)文本中的措辞与期望(目标)文本的重叠程度,对于摘要和翻译等任务特别有用。返回
precision、recall和f-measure,每个值在 0-1 范围内,分数越高表示与目标越接近。
Custom evaluation functions
自定义评估函数允许你选择之前已发布的函数。这些可以是代码仓库中编写的对象上的函数或其他 AIP Logic 函数。自定义评估函数必须至少返回一个布尔型或数值型指标。它们也可以返回字符串值,这些值会作为调试输出显示在调试视图中,用于诊断目的。一个评估函数也可以通过返回由布尔型或数值型组成的 struct 来返回多个指标。
创建评估套件后,请进一步了解评估套件运行配置。
延伸阅读 · 相关页面
按主题横向跳转,不必顺着目录一篇篇读。
本组其他页面 · AIP Evals(给 AI 做测试)
同一主题下的相邻内容。
- AIP Evals 总览:给 AI 函数做测试LLM 的输出是不确定的(non-deterministic),传统单元测试不够用。AIP Evals 是专门为此设计的
- 为 Logic 函数建立评估套件Logic 的 Preview 面板适合一次性试跑;但要建立真正的信心,必须拿大量输入去测。这篇是入门路径。
- 用中间参数评估 block 输出LLM 函数往往包含多个步骤,只看最终结果可能看不出是哪一步出了问题。这篇讲怎么评测中间 block 的输出。
- 评估 Ontology 编辑测一个会写 Ontology 的函数,难道每次都要真改数据?不用 —— 每个测试用例在 Ontology 模拟环境里跑,
- 运行评估套件套件可以从多个地方运行:AIP Logic 的 Evals 侧边栏、AIP Evals 应用。可以整跑,也可以只跑单个用
- 运行实验:系统对比参数组合想知道哪个模型性价比最高、哪版提示词效果最好?用实验系统性地跑多个参数组合,而不是靠猜。
- 把运行结果写入数据集Evals 界面不是给所有人用的。把结果写进数据集,就能在 Workshop 等应用里跟其他信息一起展示,让领域专家也能
- 分析运行结果结果视图告诉你:函数在各测试用例与评估标准上的表现具体如何。可以在 Evals 应用里看,也能在 Logic / Cha
- 在指标仪表盘查看结果把多次运行的结果收拢到一处,用图表和统计呈现,还能比较聚合结果或单个测试用例的表现。
常见问题速答 · FAQ
关于「创建评估套件」,读者最常问的几个问题。