运行评估套件
套件可以从多个地方运行:AIP Logic 的 Evals 侧边栏、AIP Evals 应用。可以整跑,也可以只跑单个用例 —— 后者是调试的利器。
https://www.palantir.com/docs/foundry/aip-evals/run-suite/
原始标题:AIP Evals • Run an evaluation suite • Palantir · 所属:AIP Evals(给 AI 做测试)
先记住这几条
写在前面
评估套件可以从不同位置运行,包括 AIP Logic 的 Evals 侧边栏和 AIP Evals 应用。你可以选择运行完整的评估套件,或只执行单个测试用例。后者对于调试和快速迭代函数非常有用。
完整套件运行
在 AIP Logic 中,导航到 AIP Evals 侧边面板并选择 Run evaluation suite。如果你有未保存的更改,则会改为显示 Save and run,以确保在运行评估套件之前保存更改。
或者,你可以从 AIP Evals 应用运行评估套件。要打开该应用,请在 AIP Logic 侧边栏中选择 View,或从文件系统中打开该评估套件。在 Evals 应用中,你可以通过选择右上角的 Run evaluation suite 来运行评估套件。
Run configuration
运行评估套件时有多个配置选项可用。要访问运行配置选项,请选择 Run evaluation suite 旁的齿轮图标。这将打开一个包含以下选项的对话框:
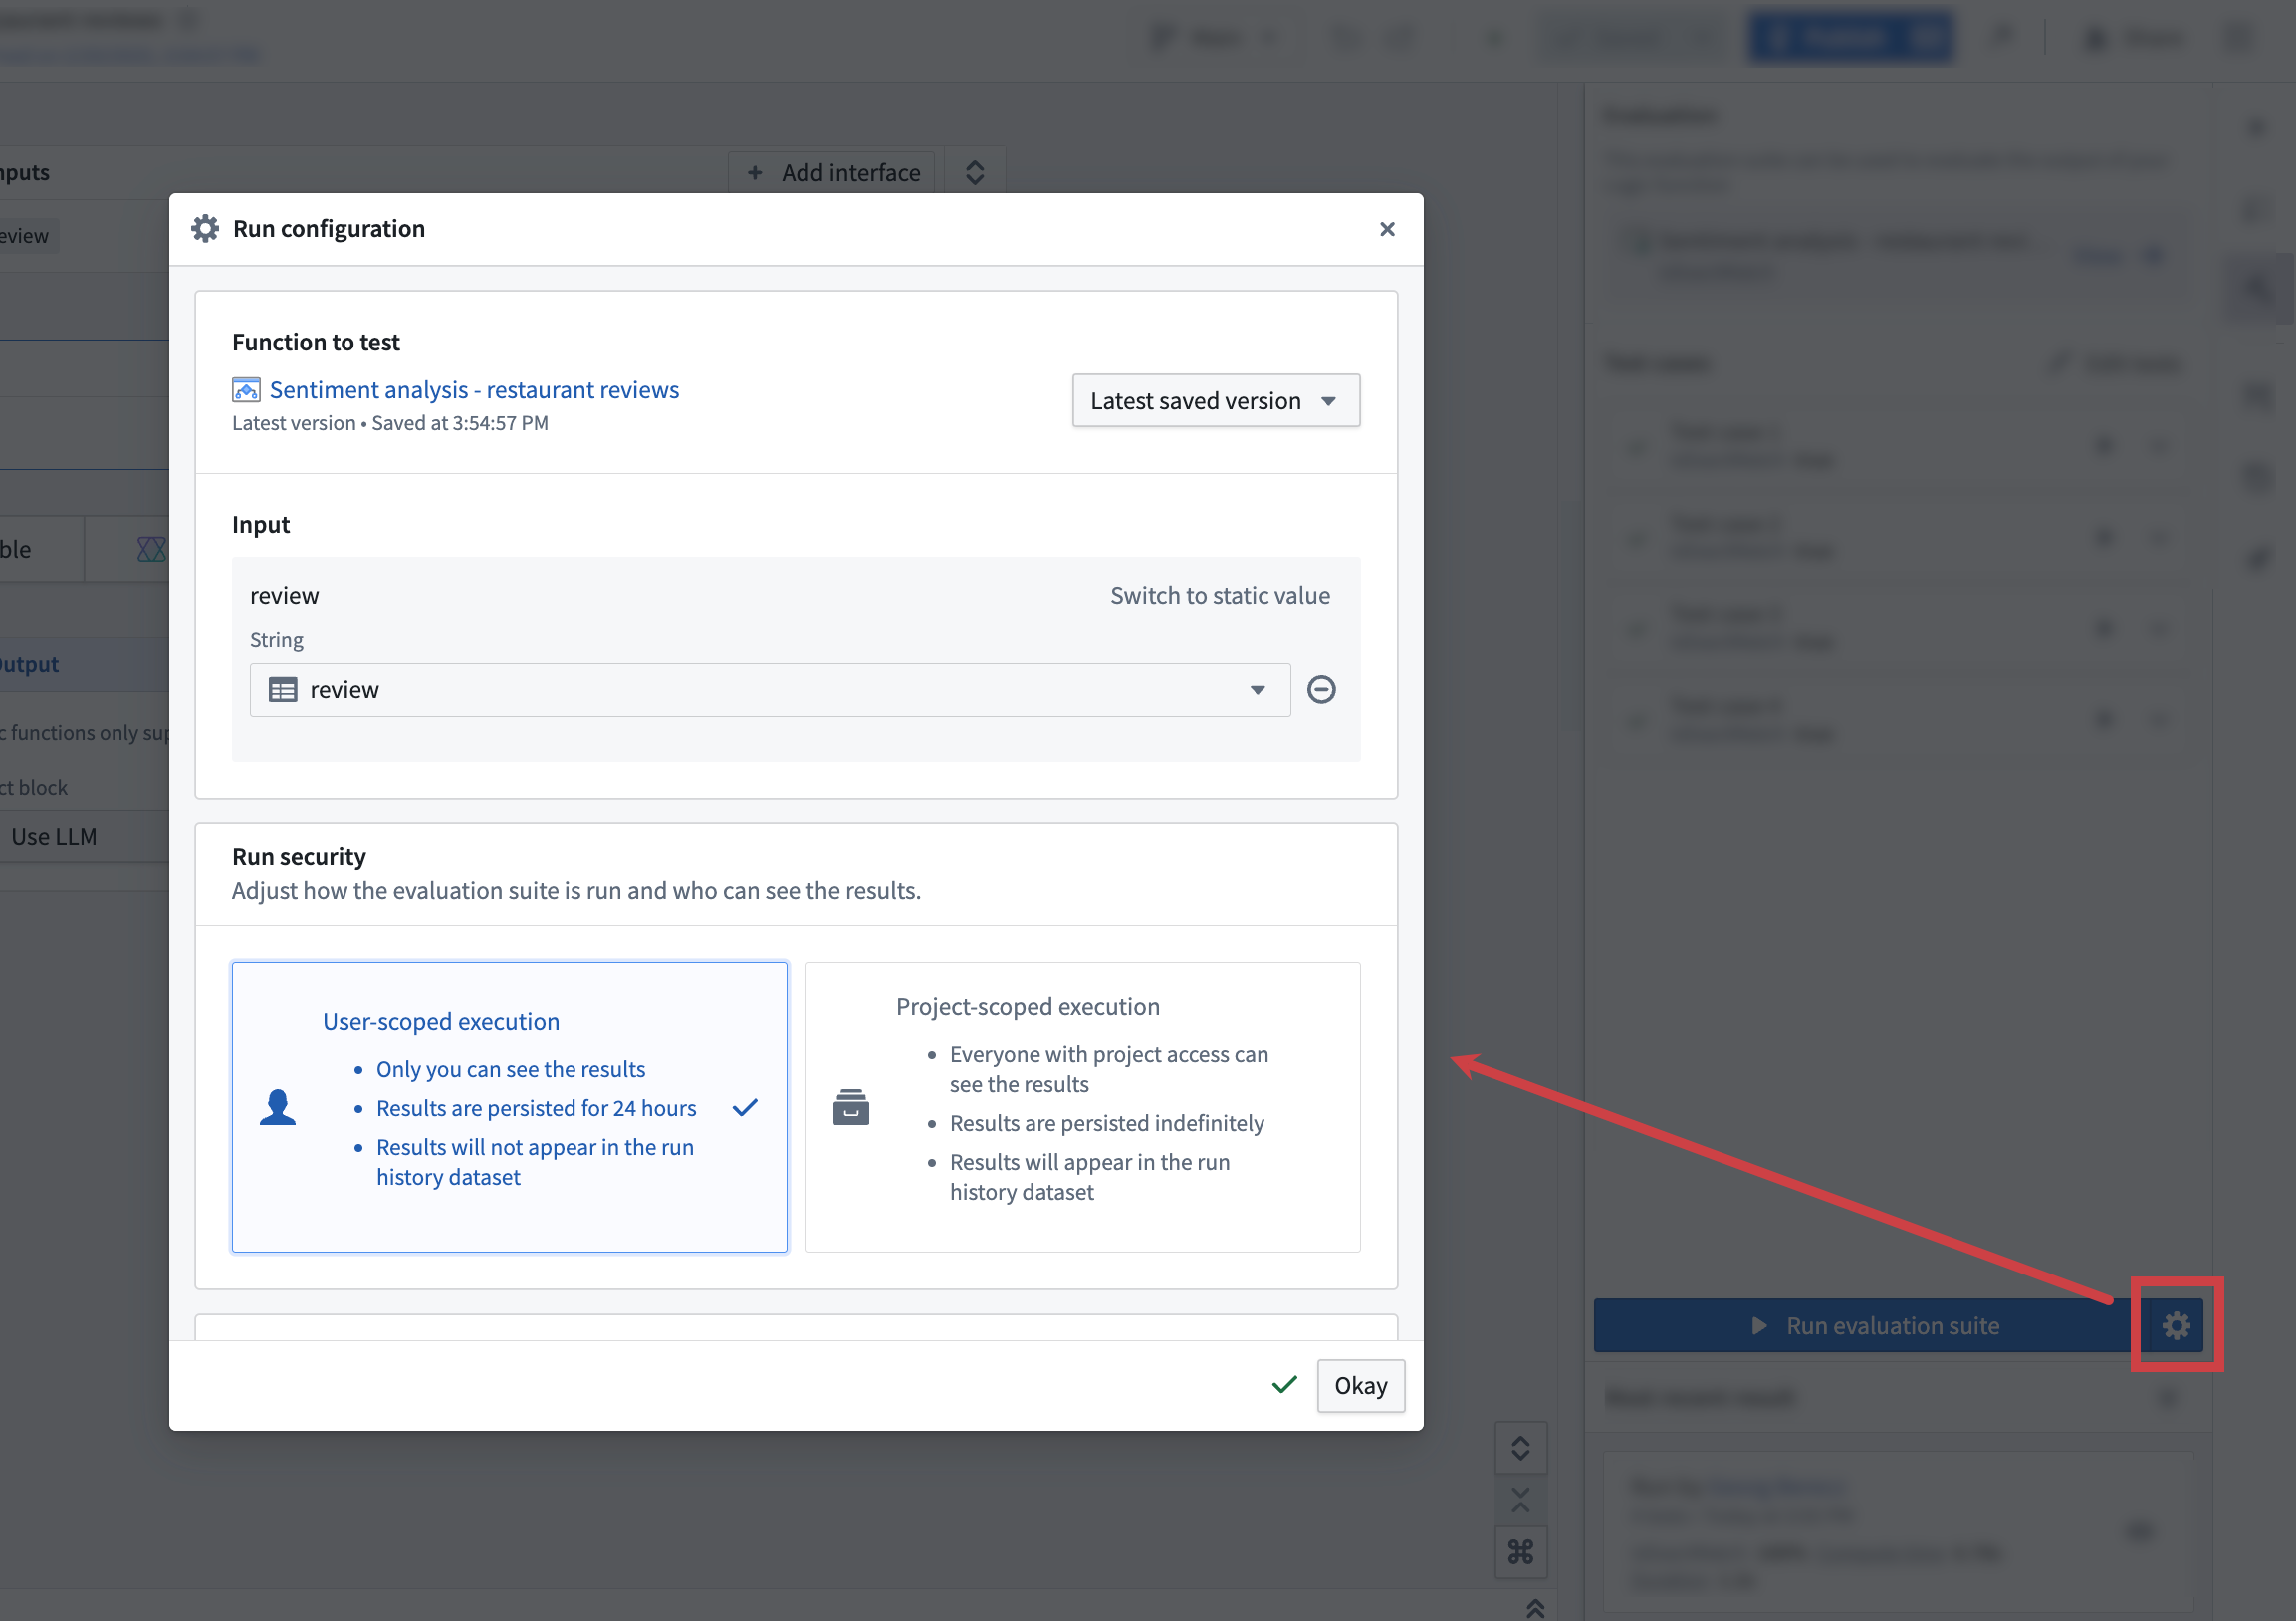
Function to test
评估套件可以针对在 AIP Logic 中编写的函数以及在代码仓库(Code repositories) 中编写的函数运行。取决于该函数的来源,你可以针对函数的不同版本:
- AIP Logic 函数: 最后保存(默认)和已发布的版本。
- 非 AIP Logic 函数: 已发布的版本。
Testing multiple functions
如果你的评估套件配置了多个目标函数,你可以在 AIP Evals 中同时针对多个函数运行评估。选择 Test multiple functions 切换到多目标模式,然后选择要包含在本次运行中的目标。
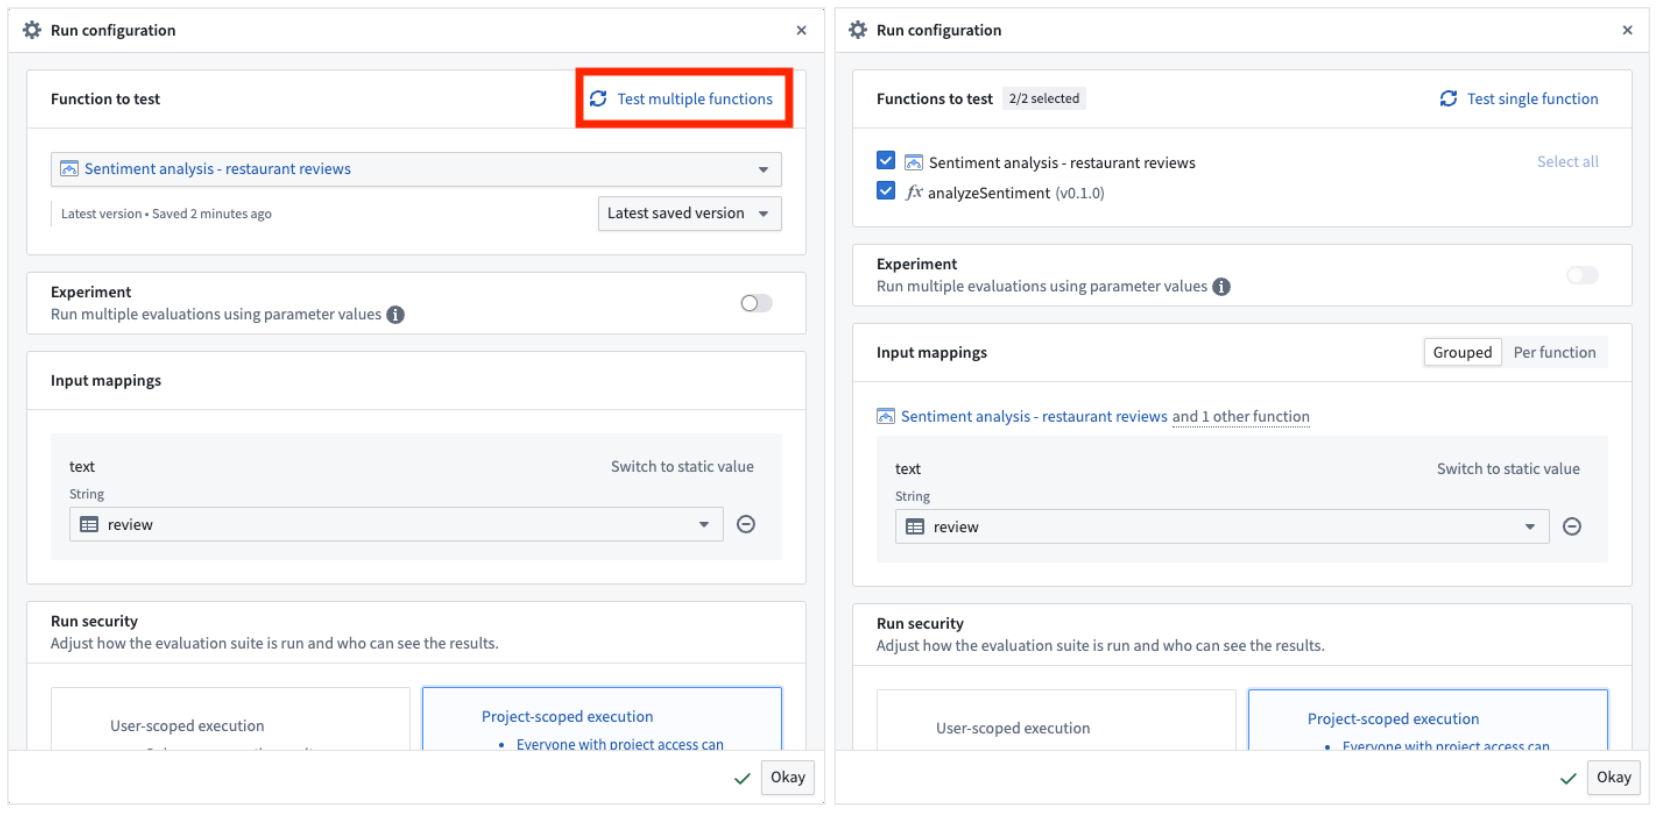
在多目标模式下运行时,实验配置不可用。
Input mapping
需要提供输入映射,以将评估套件列中的值映射到被评估函数所期望的输入。你将能够选择类型与期望函数输入匹配的套件列。
通常,评估套件列名与函数输入会一致,但这并非必需。
Execution mode
运行评估套件时,你可以在两种执行模式之间选择:User-scoped execution(用户范围执行)和 Project-scoped execution(项目范围执行)。用户范围执行是默认模式,它使用发起运行的用户的权限来执行评估套件。
用户范围执行:
- 套件以用户权限执行。
- 结果仅对你可见,并将在 24 小时后删除。
- 结果将不会持久化到结果数据集中。
项目范围执行 \[Beta]:
项目范围执行处于开发的 beta 阶段,可能并非在你的注册环境中可用。功能在活跃开发期间可能会发生变化。如果你在使用此执行模式时遇到问题,请尝试改用用户范围执行来运行评估套件。
- 评估套件以项目范围执行。这意味着在函数或评估器执行期间使用的所有资源都需要导入到同一个项目中。
- 运行结果将对所有拥有项目访问权限的人可见。
- 结果将无限期持久化。
- 如果配置了结果数据集,结果将被写入其中。
Number of iterations
你可以指定每个测试用例应运行的次数。由于 LLM 的非确定性特征,我们建议对 LLM 驱动的函数至少运行测试用例三次。每次迭代的结果会被聚合,以提供函数表现的全面概览。
像 ROUGE score 这类数值评估器中出现高方差,可能表明该测试用例和评估器没有意义,需要进一步改进。
Test parallelization
默认情况下,十个测试用例并行执行。你可以调整并行测试用例执行的数量,以优化评估套件运行的性能。在遇到速率限制时,减少该数量可能是有益的。
Run metadata
除了自动捕获的运行元数据(如 used branch、version 或 model)之外,你还可以向评估套件运行添加自定义元数据。 这些元数据以键值对的形式提供,可用于在评估套件运行历史中区分不同的运行。
View results
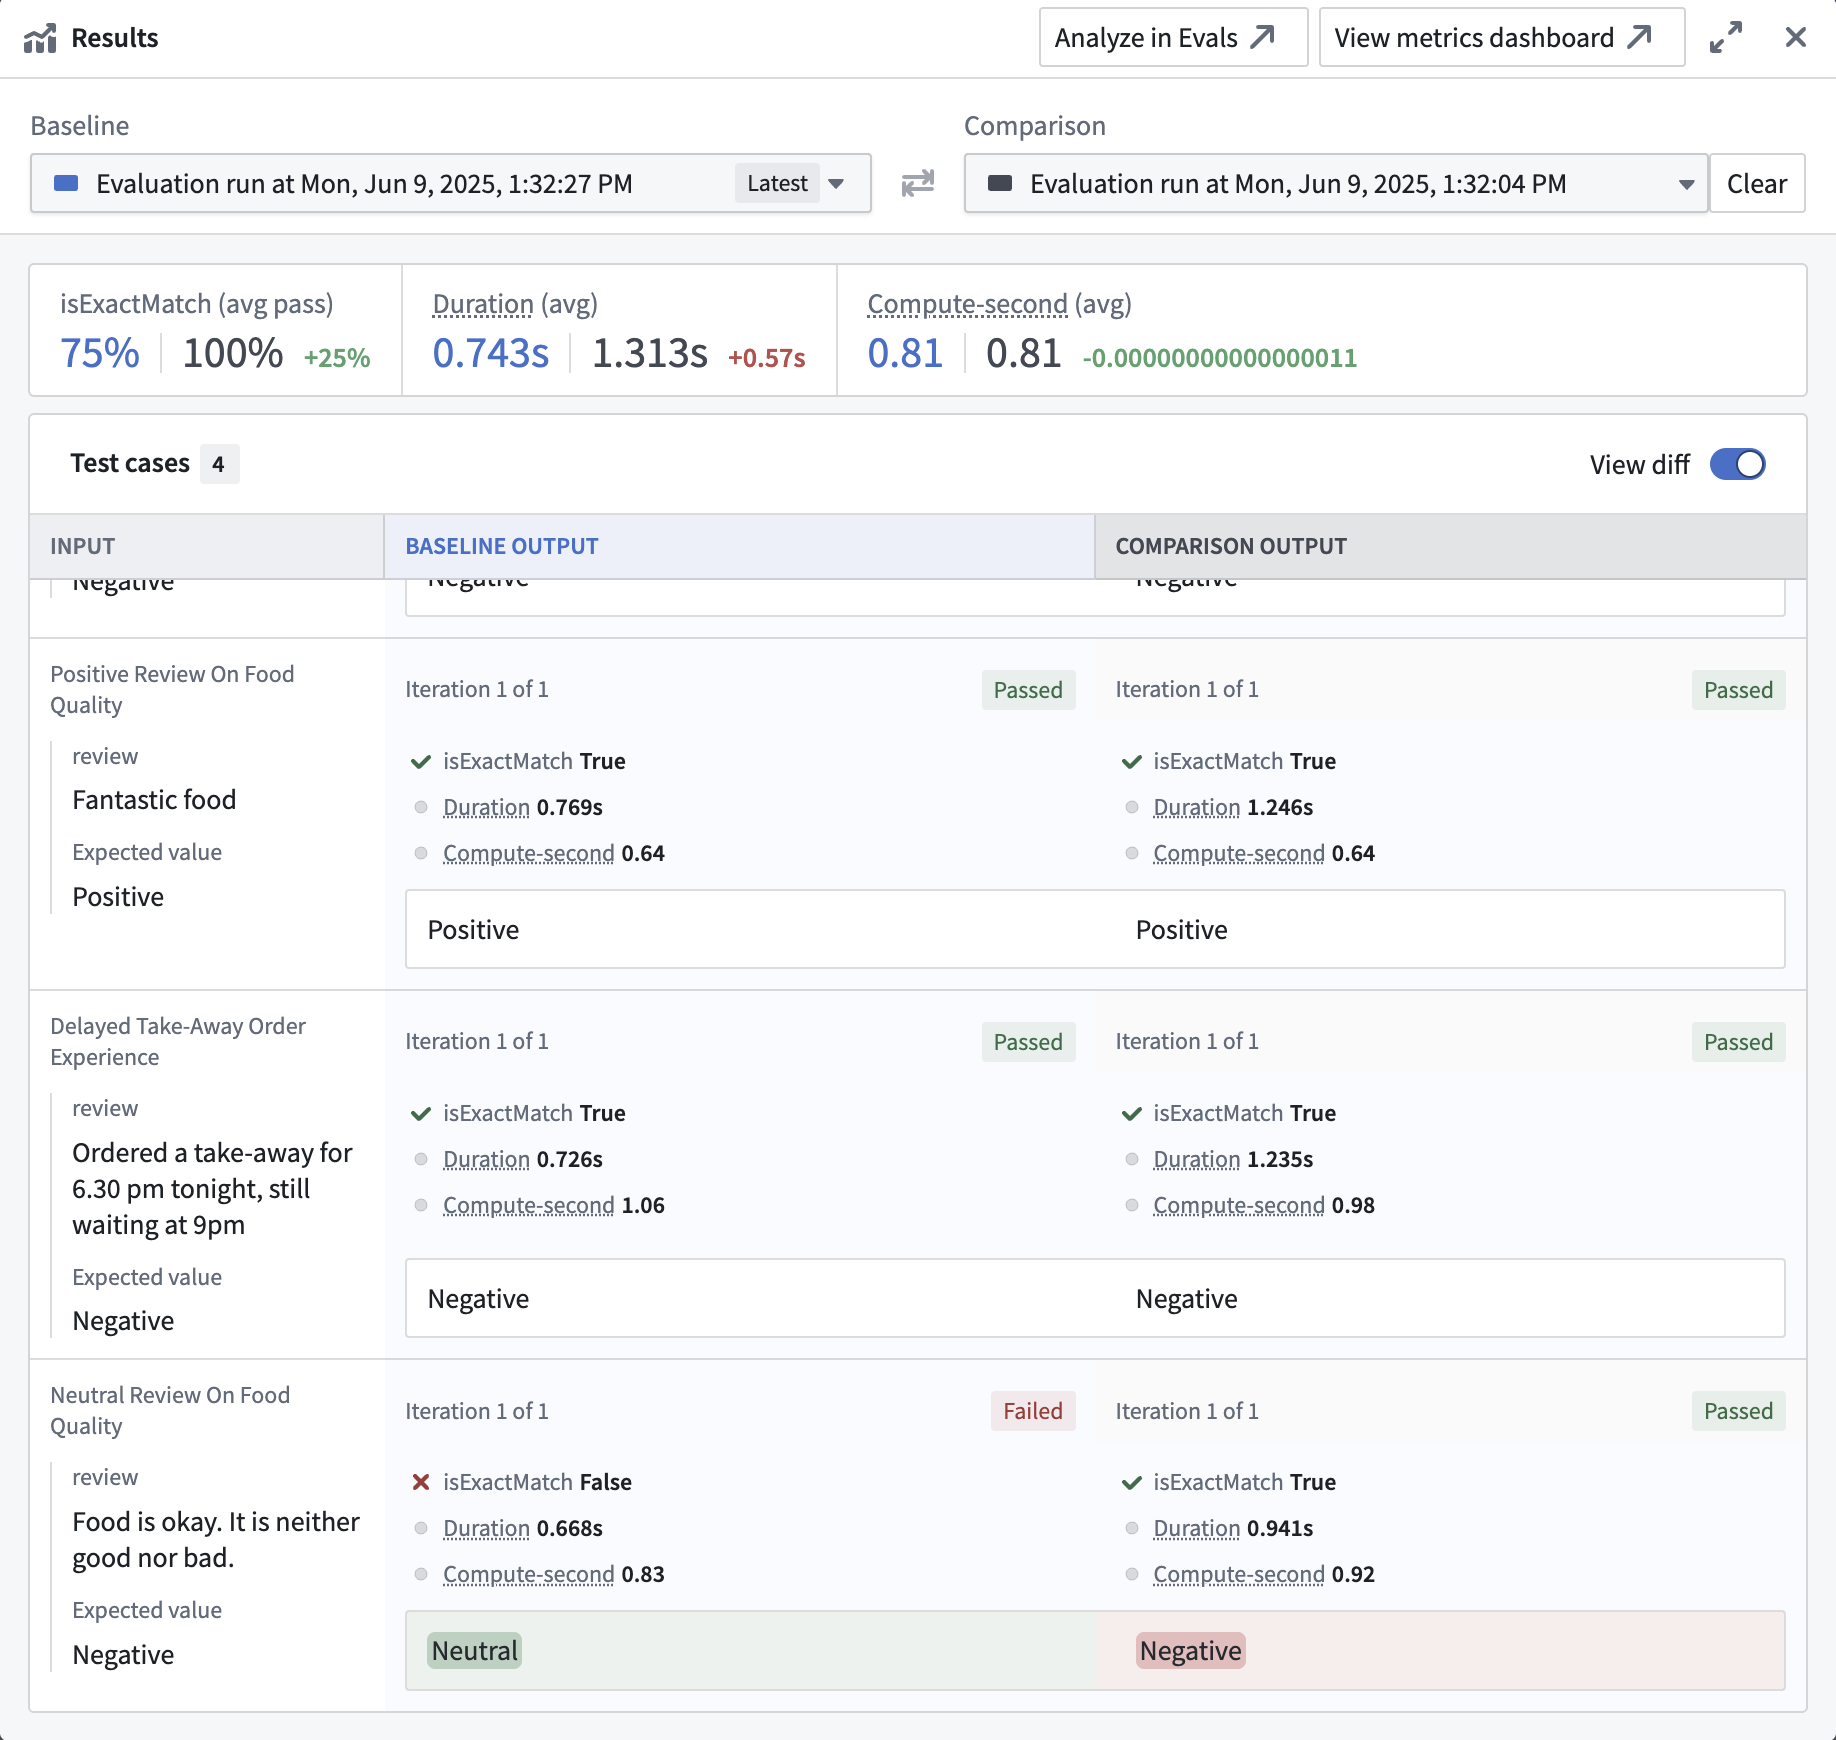
评估套件运行完成后,你可以通过选择 Most recent result 区域中的卡片来查看结果。这将打开结果视图,你可以在其中看到评估套件运行的聚合指标,以及每个单独测试用例的结果。每个指标的 passed 或 failed 状态会根据你所配置的目标(布尔型或数值型、方向、阈值)显示。将鼠标悬停在单个测试用例上时,你将能够看到测试用例结果右下角的调试器按钮。选择它将在一个新标签页中打开该测试用例的调试视图。调试视图将显示该测试用例所执行的 Logic 函数和评估器的各个步骤。
此外,结果视图还提供了通过选择 Click to compare another run 来比较运行的功能。这将在当前运行旁并排打开另一次运行,让你能够比较两次运行的结果。默认情况下,View diff 开关将被启用,从而高亮显示两次运行之间的输出差异。
单测试用例执行
运行单个测试用例时,也会根据你所设置的目标(布尔型或数值型、方向、阈值)显示每个指标的 passed 或 failed 状态。
AIP Logic 中的 AIP Evals 侧边栏提供了一种运行单个测试用例的快捷方式。这在构建你的 Logic 函数时,或在完整评估套件运行后对失败的测试用例进行迭代时特别有用。
要运行单个测试用例,请选择侧边栏中测试用例名称旁的播放图标。这将立即执行该测试用例并打开调试器侧边面板。在这里,你将能够跟踪针对测试用例结果所运行的 Logic 函数和评估器的执行过程。此外,该测试用例将在侧边栏中被标记为已执行。
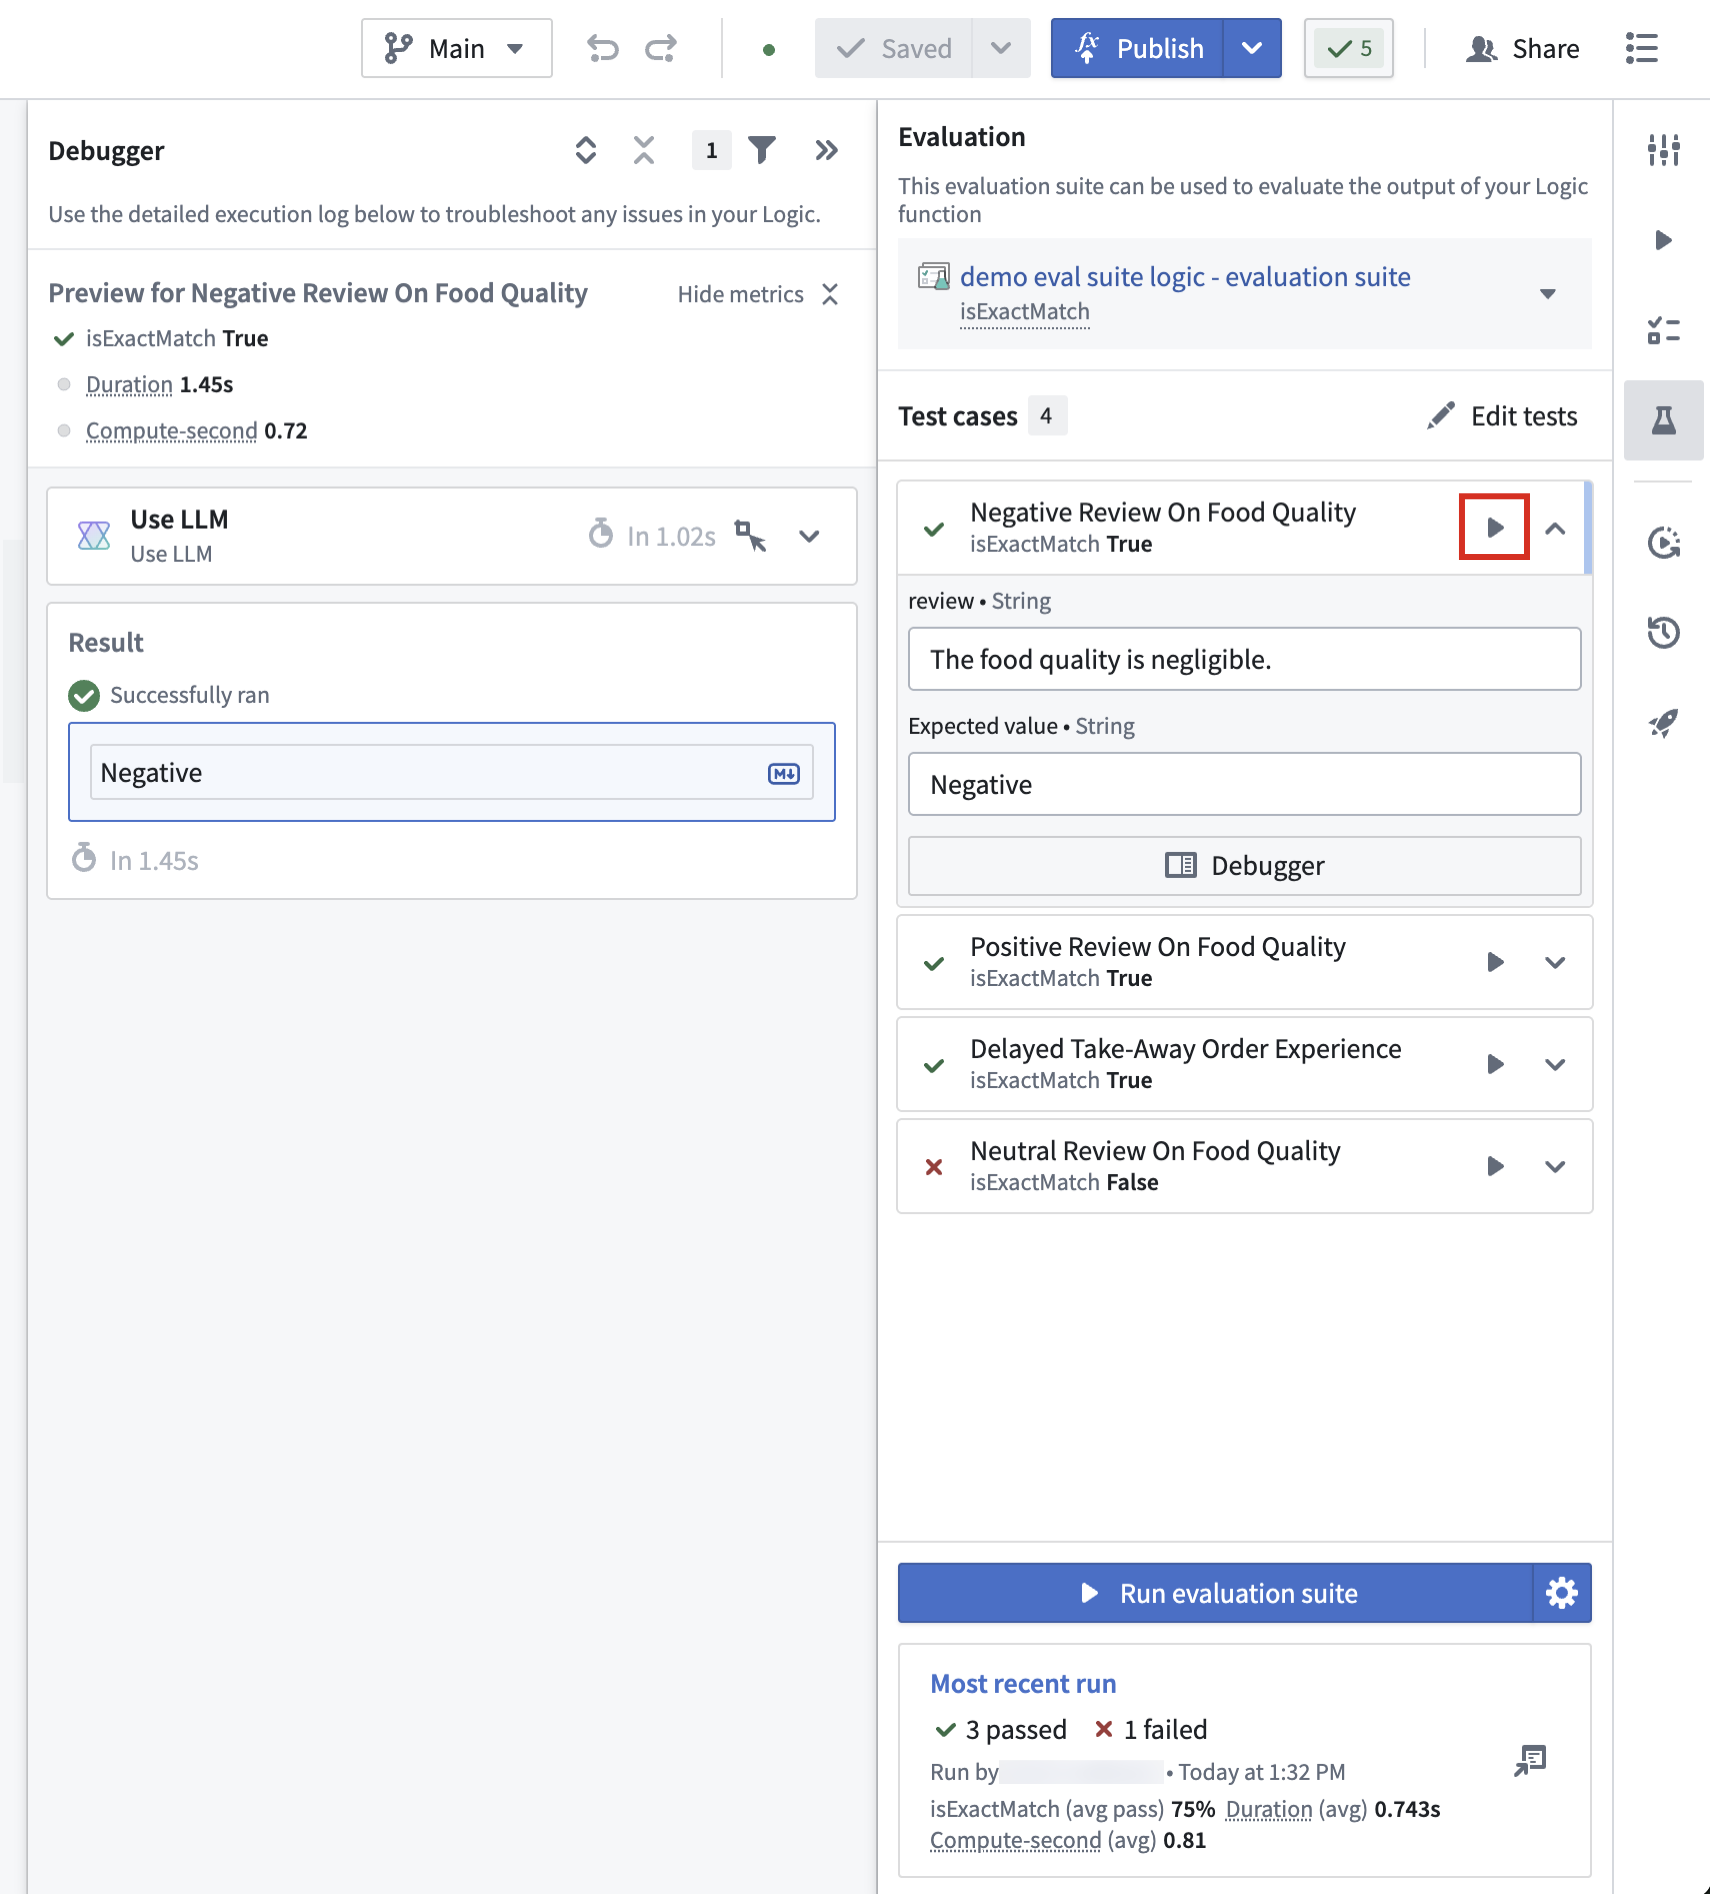
执行后,侧边栏和结果面板将根据你所配置的目标,指示每个指标是通过还是失败。
延伸阅读 · 相关页面
按主题横向跳转,不必顺着目录一篇篇读。
本组其他页面 · AIP Evals(给 AI 做测试)
同一主题下的相邻内容。
- AIP Evals 总览:给 AI 函数做测试LLM 的输出是不确定的(non-deterministic),传统单元测试不够用。AIP Evals 是专门为此设计的
- 为 Logic 函数建立评估套件Logic 的 Preview 面板适合一次性试跑;但要建立真正的信心,必须拿大量输入去测。这篇是入门路径。
- 创建评估套件评估套件 = 测试用例 + 目标函数 + 评估函数。这篇讲怎么把它搭起来,包括同时测多个目标函数的做法。
- 用中间参数评估 block 输出LLM 函数往往包含多个步骤,只看最终结果可能看不出是哪一步出了问题。这篇讲怎么评测中间 block 的输出。
- 评估 Ontology 编辑测一个会写 Ontology 的函数,难道每次都要真改数据?不用 —— 每个测试用例在 Ontology 模拟环境里跑,
- 运行实验:系统对比参数组合想知道哪个模型性价比最高、哪版提示词效果最好?用实验系统性地跑多个参数组合,而不是靠猜。
- 把运行结果写入数据集Evals 界面不是给所有人用的。把结果写进数据集,就能在 Workshop 等应用里跟其他信息一起展示,让领域专家也能
- 分析运行结果结果视图告诉你:函数在各测试用例与评估标准上的表现具体如何。可以在 Evals 应用里看,也能在 Logic / Cha
- 在指标仪表盘查看结果把多次运行的结果收拢到一处,用图表和统计呈现,还能比较聚合结果或单个测试用例的表现。
常见问题速答 · FAQ
关于「运行评估套件」,读者最常问的几个问题。